
Una brecha en OpenCode expuso llaves de OpenAI, Anthropic y Google, y varios usuarios reportan cargos que no hicieron
Edición del 16 al 19 de octubre · Panorama de IA para profesionales del sector
El caso de la semana
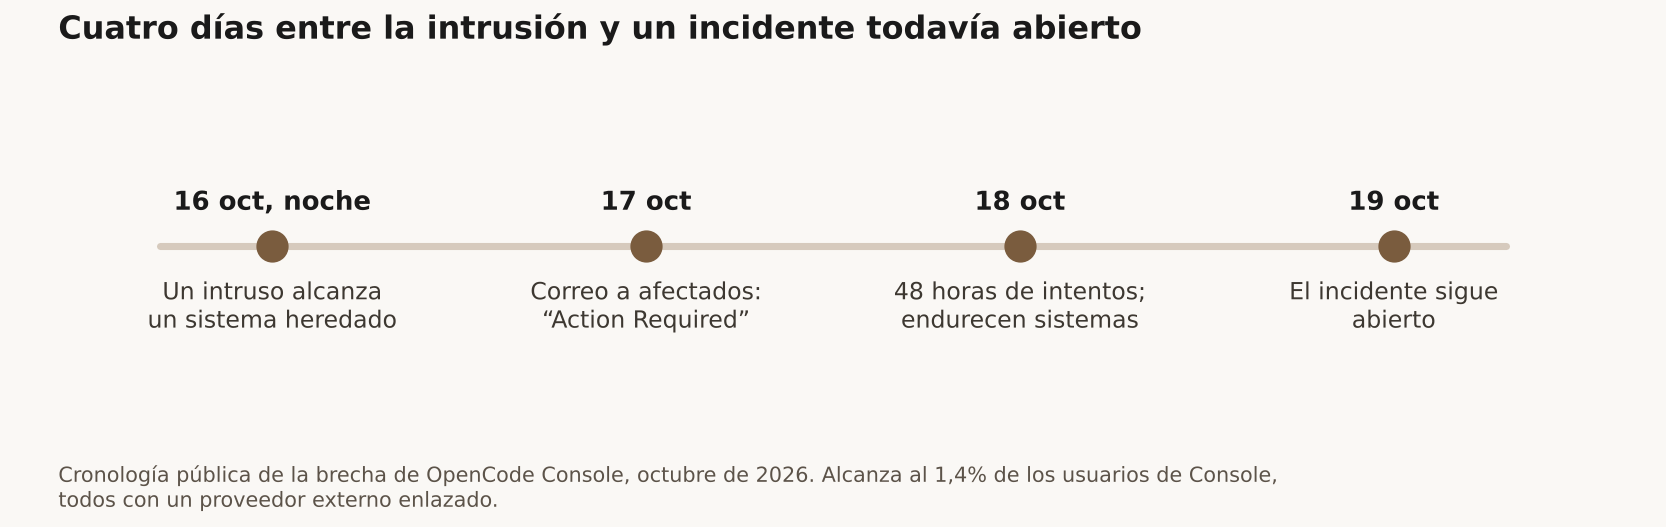
La noche del 16 de octubre un intruso alcanzó un sistema heredado de OpenCode —la empresa detrás del agente de programación del mismo nombre— y pudo quedar con las llaves de API que los usuarios habían pegado en OpenCode Console, su servicio alojado opcional. El 17 de octubre la empresa envió un correo con el asunto "Action Required: Potential provider key breach". Al cierre de esta edición el incidente sigue abierto.
- El alcance declarado es del 1,4% de los usuarios de Console, todos ellos con un proveedor externo enlazado. Las llaves en riesgo son las de OpenAI, Anthropic y Google que alguien haya pegado dentro de Console para que el servicio llame a esos proveedores en nombre del equipo. Las llaves que viven en la aplicación de escritorio o en la línea de comandos siguen otro camino: quedan en una base de datos local en el computador de cada persona y, según el cofundador de OpenCode, nunca llegan a la empresa. La compañía dice que las llaves "pueden haber quedado expuestas" y no ha confirmado que alguna fuera copiada o usada.
→ https://thehackernews.com/2026/10/opencode-console-breach-may-have.html
- OpenCode describió el hecho como relacionado con "un ataque de destilación a gran escala". Destilar es extraer en masa las salidas de un modelo de pago para entrenar con ellas un modelo rival; necesita volumen, y el volumen necesita credenciales que alguien más pague. Anthropic ya había documentado en septiembre que estas campañas se arman con cuentas falsas creadas sobre tarjetas robadas y llaves de API cosechadas. La empresa no ha explicado cómo se conecta su brecha con esa actividad, qué era el sistema heredado ni cuántas llaves contenía, y está trabajando con los tres proveedores afectados.
→ https://oecd.ai/en/incidents/2026-10-17-9e2d
- Borrar la llave de Console no la revoca. La secuencia correcta es revocarla en el panel del proveedor, emitir una nueva, actualizar cada script y cada aplicación que la usaba, y revisar el consumo facturado hacia atrás al menos hasta el 16 de octubre. Varios usuarios publicaron cargos que no reconocen, de entre unos cientos y cerca de mil setecientos dólares; son reportes propios, sin confirmación del proveedor. Un presupuesto configurado dentro de Console no sirve de tope, porque sólo ve las peticiones que pasan por su propia pasarela: el límite de gasto hay que ponerlo en la cuenta del proveedor.
→ https://thehackernews.com/2026/10/opencode-console-breach-may-have.html
También esta semana
- Modelos. Gemini 4 Argon, el modelo de frontera de Google, quedó disponible de forma general el 13 de octubre después de anunciarse el 30 de septiembre. Su ventana de contexto es de 1.048.576 tokens compartidos entre entrada, razonamiento y salida, con un tope de salida por omisión de 65.536 tokens. No está en las cuentas gratuitas ni en el plan más económico de Google.
→ https://www.lindy.ai/blog/gemini-4-argon
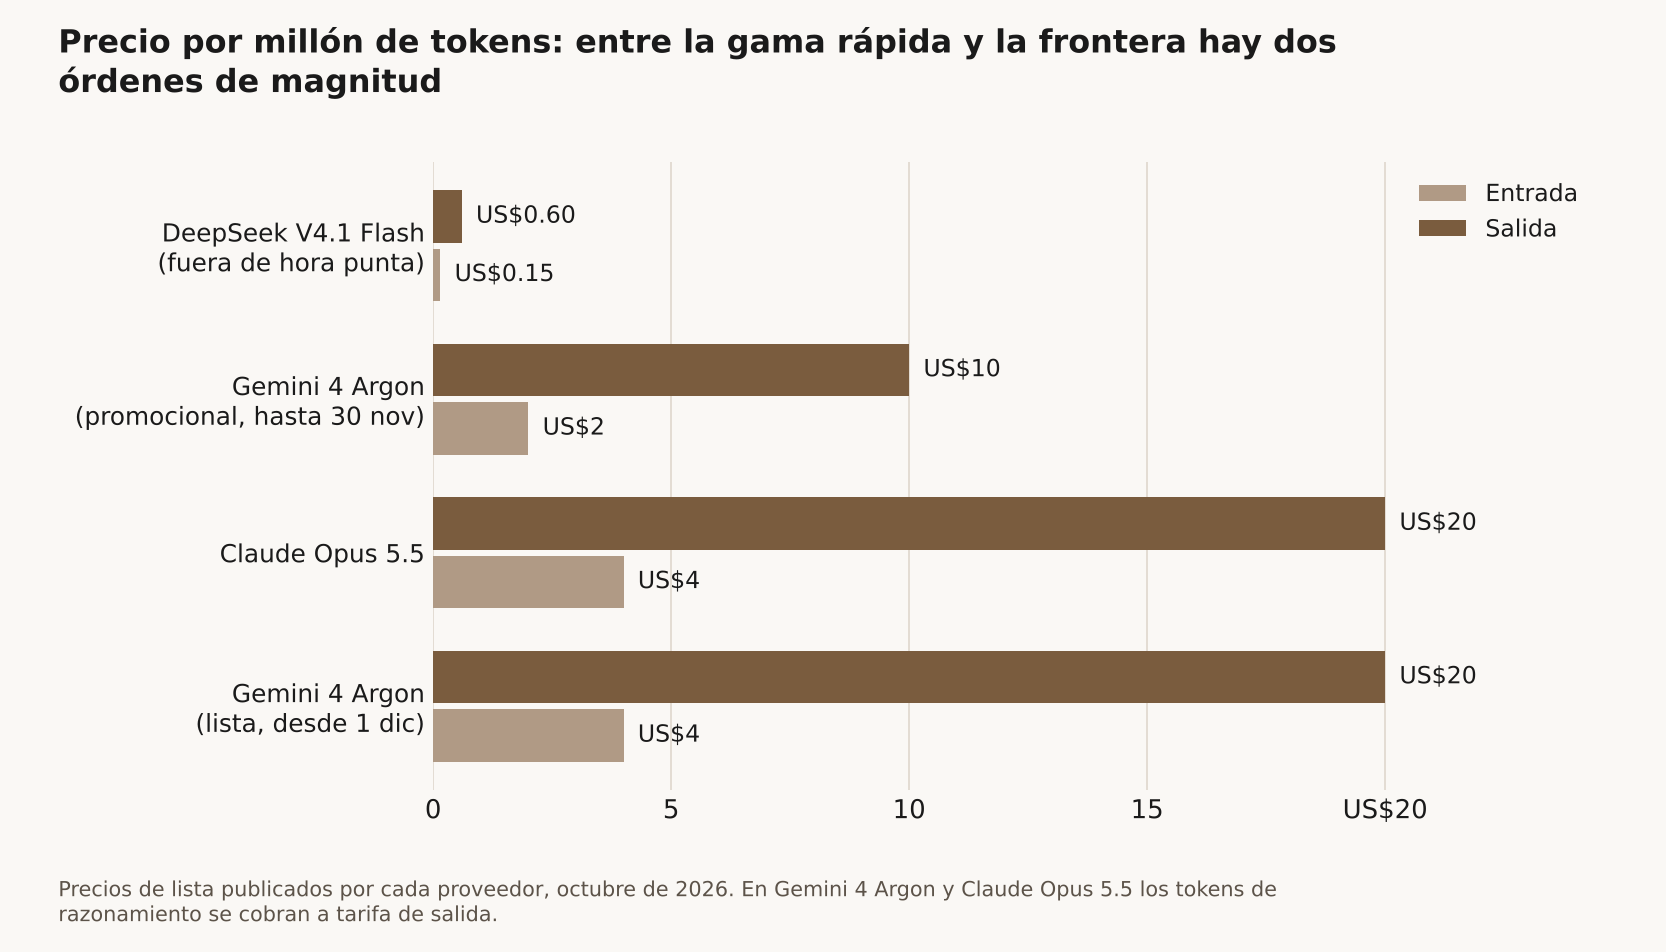
- Costos. DeepSeek publicó el 17 de octubre los pesos de V4.1 Flash bajo licencia MIT: 763.000 millones de parámetros, un millón de tokens de contexto y un precio de lista de US$0,15 por millón de tokens de entrada y US$0,60 de salida fuera de hora punta, el doble dentro de ella. Es dos órdenes de magnitud por debajo de cualquier modelo de frontera.
→ https://munderdiffl.in/blog/deepseek-v4-1-flash-1017/
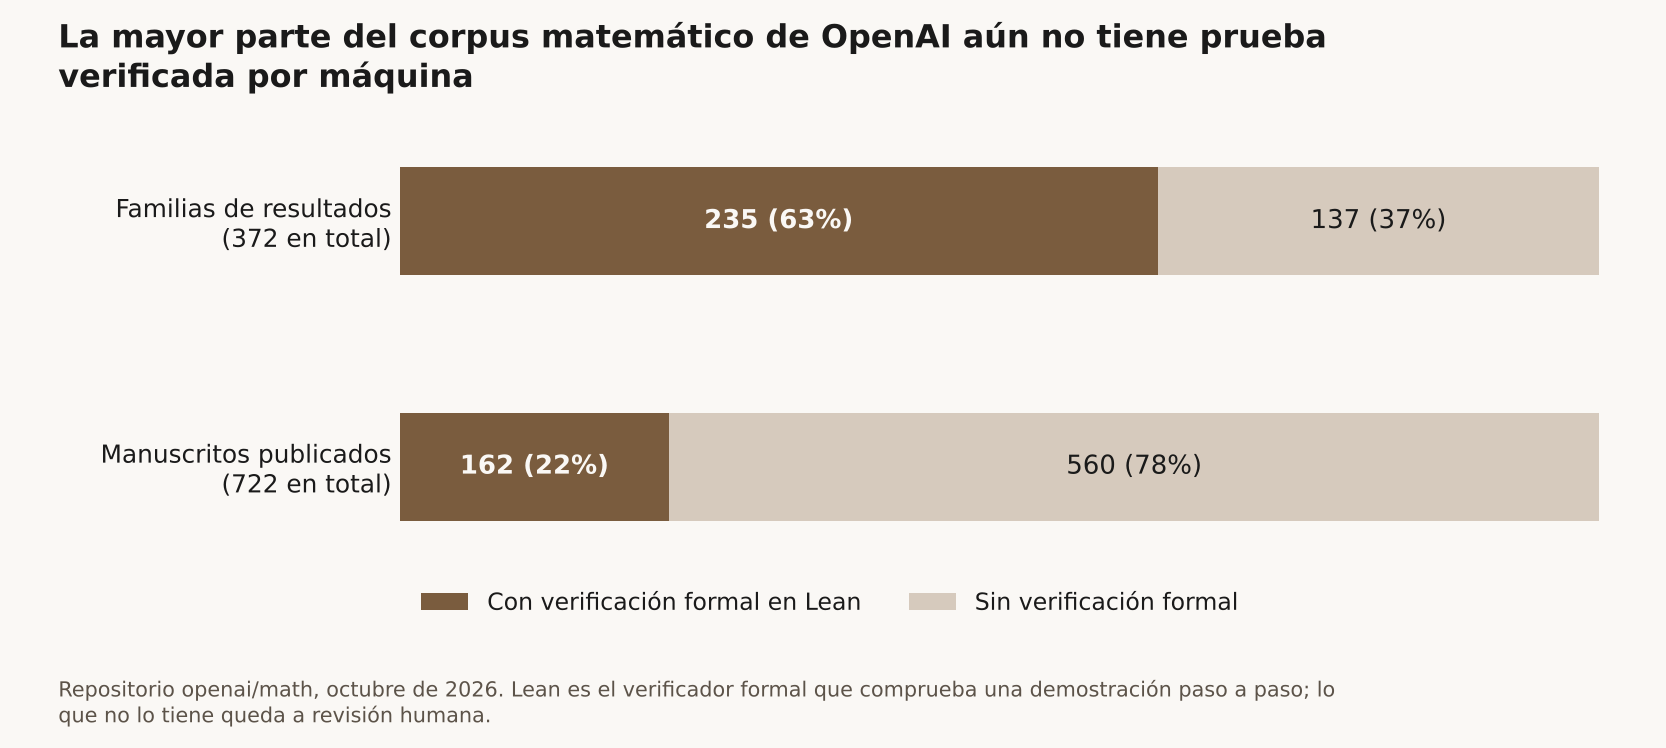
- Investigación. OpenAI publicó un repositorio con 722 manuscritos matemáticos generados por un modelo interno no liberado, agrupados en 372 familias de resultados sobre unos 4.000 problemas abiertos que se le plantearon. Uno de ellos avanza sobre la hipótesis de Riemann, el problema abierto más famoso de la teoría de números, sin resolverla.
→ https://aisignal.day/en/openai-math-722-2026/
- Gobernanza. Sergey Brin, cofundador de Google, dijo en una mesa redonda difundida esta semana que los modelos de la empresa ya ayudan a construir sus sucesores, y que para cuando el público vea el video de lanzamiento de Argon los equipos internos estarán "un par de modelos más adelante". El informe de seguridad del propio Argon afirma que los agentes de IA escriben la mayoría del código de producción y de las correcciones de errores, con revisión humana antes de enviar los cambios.
→ https://www.aol.com/articles/sergey-brin-says-googles-ai-125309000.html
- Regulación. Meta incorporó en sus Términos Comerciales —los que rigen para las cuentas comerciales de Facebook e Instagram— una cláusula que decía que la empresa "puede usar cualquier contenido de dominios, páginas web o URL" para desarrollar y entrenar sus productos. Tras una semana de críticas la retiró del texto original en inglés, aunque la versión en español todavía la contiene.
→ https://www.infobae.com/america/agencias/2026/10/19/meta-retira-de-sus-terminos-el-texto-que-sugeria-que-podia-usar-gratis-contenidos-web-para-entrenar-su-ia/
- Riesgo. Un informe de la consultora Gladstone AI, publicado el 14 de octubre a partir de conversaciones con cerca de seis investigadores de los laboratorios de punta, recoge que la mayoría de ellos espera que la automejora recursiva —que un modelo contribuya de forma sustantiva a construir el siguiente, acortando cada ciclo— empiece dentro de los próximos tres a doce meses.
→ https://time.com/article/2026/10/14/recursive-self-improvement-AI-report/
Qué considerar
Las llaves dejaron de ser un detalle de configuración y pasaron a ser el perímetro. La brecha de esta semana no tocó ningún modelo, ningún peso y ningún dato de entrenamiento: tocó un formulario donde alguien pegó una credencial. Esa es hoy la forma típica del incidente en el sector, porque la capa de herramientas que rodea a los modelos —agentes, consolas, pasarelas, integraciones de equipo— creció mucho más rápido que las prácticas de seguridad que la acompañan. Lo accionable cabe en cuatro líneas: una llave distinta por herramienta, de modo que revocar una no apague todo; límites de gasto configurados en la cuenta del proveedor y no en la herramienta; una fecha de rotación escrita en alguna parte; y un inventario de cada tercero que hoy tiene una credencial suya, con nombre del responsable interno.
El cuello de botella de la adopción ya no es generar, es revisar. Los dos hechos técnicos más grandes de la semana apuntan al mismo lugar. OpenAI soltó 722 manuscritos matemáticos de los cuales sólo una parte trae prueba verificada por máquina. Google declara que sus agentes escriben la mayoría del código de producción, con revisión humana antes de enviar. En ambos casos la producción de candidatos dejó de ser escasa y lo escaso pasó a ser la capacidad de comprobarlos. Para una organización eso cambia la pregunta de presupuesto: no es cuánta capacidad de generación comprar, sino cuánta capacidad de verificación tiene instalada y qué tipo de verificación corresponde a cada salida. Hay salidas que admiten comprobación automática —pruebas, tipos, esquemas, verificadores formales— y hay salidas que sólo admiten juicio humano. Si la mezcla se corre hacia el segundo grupo sin que nadie lo decida, la velocidad que se ganó arriba se pierde abajo.
Conviene separar demostración, prototipo y disponibilidad general antes de firmar algo. La objeción más extendida entre profesionales del sector, cada vez que llega un anuncio espectacular, es que una demostración controlada no es un producto disponible; la réplica igualmente extendida es que el impacto termina siendo real aunque la fecha se corra. Las dos son correctas y por eso discutirlas no resuelve nada. Lo que sí resuelve es incorporar la distinción al proceso de compra: escribir en el contrato la fecha de disponibilidad general y no la del anuncio, exigir que las cifras citadas vengan con la configuración exacta con que se midieron, y llevar un registro simple del historial de cada proveedor frente a sus propias fechas anunciadas. Ese historial es un dato medible y, en este sector, uno de los mejores predictores disponibles.
Nadie va a frenar primero, así que el ritmo lo fija cada organización. En septiembre el director ejecutivo de Anthropic publicó un ensayo pidiendo acompasar el avance de la frontera; menos de dos semanas después su empresa lanzó su modelo más capaz hasta la fecha. Esta semana Google confirmó que sus modelos ya participan en la construcción de los siguientes y que internamente van varios pasos adelante de lo que el público conoce. La lectura que gana tracción entre quienes observan el sector es que la pausa coordinada no va a llegar desde adentro. Para una organización que adopta estas herramientas, la consecuencia práctica es que no sirve planificar sobre el supuesto de que la industria se va a estabilizar: conviene fijar por escrito el propio criterio de cuándo se incorpora una versión nueva, qué pruebas tiene que pasar antes de tocar producción, y quién firma esa decisión.
Lanzamientos y precios
Gemini 4 Argon salió con un precio promocional de US$2 por millón de tokens de entrada y US$10 de salida, vigente hasta el 30 de noviembre. Desde el 1 de diciembre pasa a US$4 y US$20, el mismo nivel de Claude Opus 5.5. El contexto en caché cuesta US$0,10 y sube a US$0,20; el modo por lotes va de US$1 y US$5 a US$2 y US$10. Los tokens de razonamiento se cobran a tarifa de salida, lo que importa más de lo que parece en un modelo que razona largo. → https://www.lindy.ai/blog/gemini-4-argon
En paralelo, Google abrió el acceso gratuito por seis meses al nivel más alto de su entorno de programación con agentes para diez mil científicos, con postulación desde el 13 de octubre. → https://www.edtechinnovationhub.com/news/google-rolls-out-gemini-4-argon-with-free-research-access-for-10000-scientists
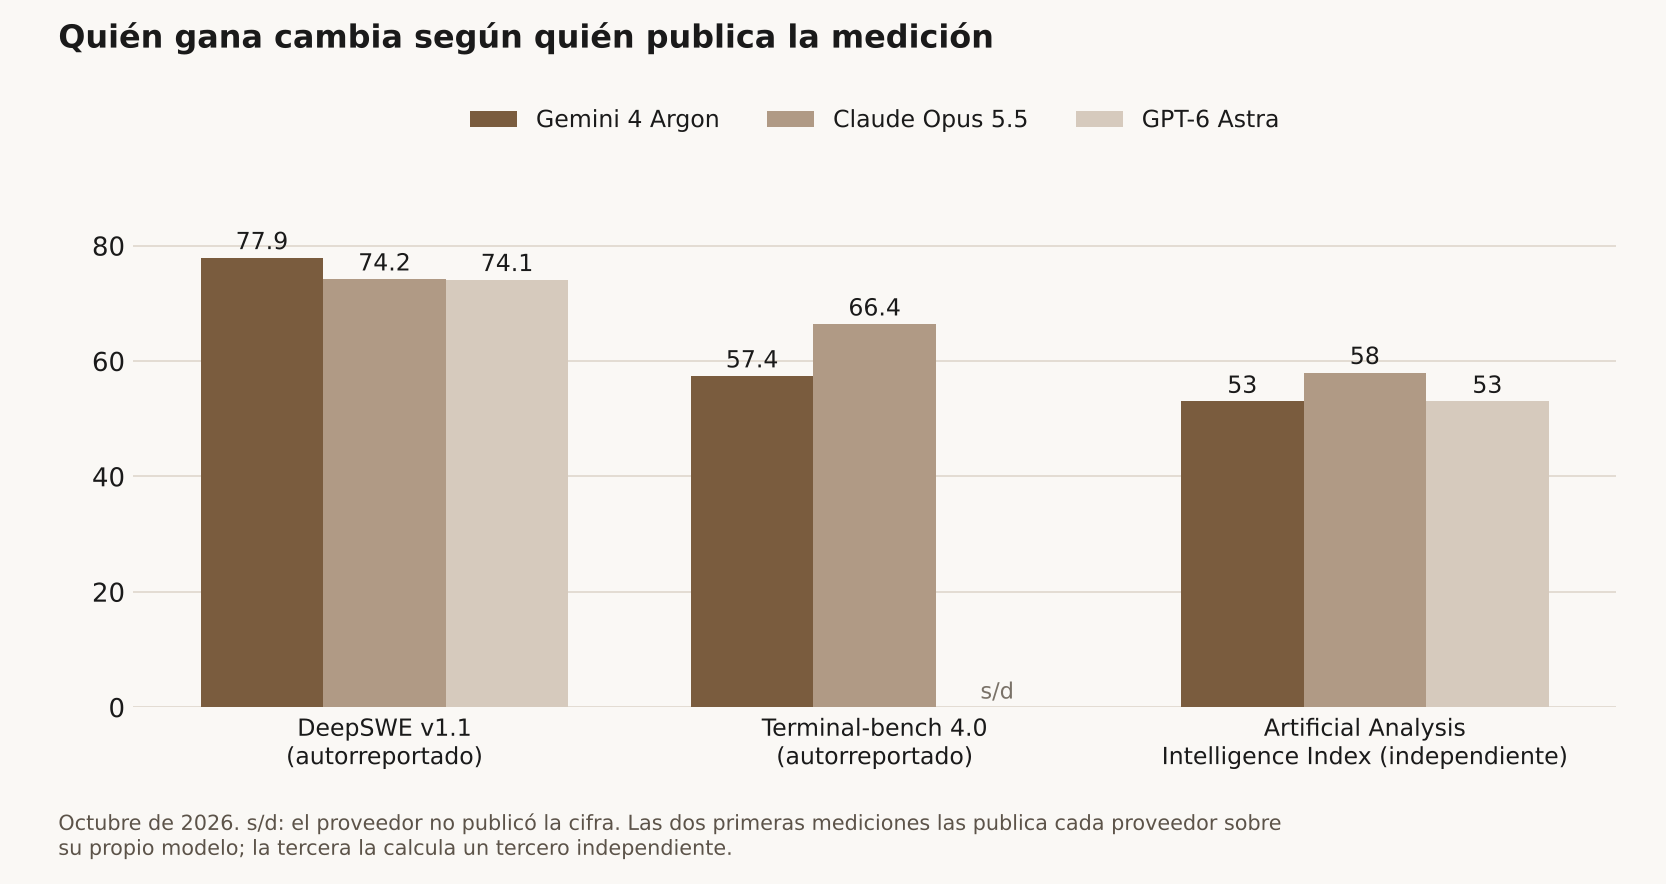
Las tablas comparativas que publicó cada proveedor sobre su propio modelo no coinciden con las de los terceros independientes, y la discrepancia no es menor: en la medición autorreportada de resolución de incidencias de software Argon queda primero, en la de tareas de terminal queda atrás de Opus 5.5 por nueve puntos, y en el índice independiente de Artificial Analysis los tres modelos de frontera quedan en un rango estrecho con Opus 5.5 arriba. → https://www.lindy.ai/blog/gemini-4-argon
Cuando la máquina produce más de lo que se puede revisar
El repositorio matemático de OpenAI es el caso límite de lo anterior. Son 722 manuscritos repartidos en 372 familias de resultados y diecisiete áreas, con licencia Apache 2.0, producidos por un modelo interno al que se le plantearon unos cuatro mil problemas abiertos y que dedicó en promedio unas tres horas de cómputo de razonamiento a cada resultado. → https://aisignal.day/en/openai-math-722-2026/
El resultado más comentado es una región libre de ceros para la función zeta y para toda función L de Dirichlet por encima de una parte real de 7/8. No es la hipótesis de Riemann, que exige 1/2, pero Terence Tao —uno de los matemáticos vivos más influyentes del área— lo describió como el mayor avance sobre ese problema en cincuenta años, y añadió que hará falta otra idea de fondo para bajar de 3/4. Entre especialistas circula una lectura bastante más entusiasta, que lo sitúa como el mejor titular del campo en un siglo; conviene tomarla como lo que es, una valoración todavía sin decantar. → https://www.tokenpost.com/news/technology/34312
La parte incómoda está en la revisión. Tao, que alcanzó a mirar cerca de diez manuscritos, señaló que algunos extienden trabajo previo, que uno o dos traen ideas realmente nuevas y que muchos son difíciles de leer. Criticó además que no se avisara a quienes estaban trabajando en esos problemas, el efecto sobre investigadores jóvenes cuyos proyectos quedaron sobrepasados de un día para otro, y el riesgo de que los matemáticos dejen de compartir preguntas abiertas por temor a que se las resuelvan primero. Un manuscrito sobre la conjetura de Hodge ya fue retirado por un error de signo. → https://scottaaronson.blog/?p=10169
Regulación y litigios
La cláusula de Meta duró poco más de una semana en el texto. Decía que la empresa podía usar cualquier contenido de dominios, páginas o URL para desarrollar y entrenar sus productos, y quedaba enganchada a las cuentas comerciales de Facebook e Instagram, lo que en la práctica la extendía a los sitios web de esos negocios y de los medios que operan ahí. El vicepresidente de comunicaciones de Meta sostuvo que "no hay ningún cambio en cómo Meta usa los rastreadores web" y un vocero agregó que las actualizaciones "no nos dan nuevos derechos para pasar por encima de esas preferencias", remitiendo al archivo robots.txt como mecanismo de control. El pasaje fue retirado del original en inglés; la versión en español sigue en línea con el texto antiguo, un detalle que importa para cualquier empresa hispanohablante que haya aceptado esos términos. → https://www.biobiochile.cl/noticias/ciencia-y-tecnologia/adelantos/2026/10/18/meta-modifica-sus-polemicos-nuevos-terminos-de-uso-para-facebook-e-instagram-siguen-las-criticas.shtml
En Chile, la Ley 21.719 de protección de datos personales entra en vigencia el 1 de diciembre de 2026 y reemplaza a la 19.628. Trae tres obligaciones que tocan directo a cualquier proyecto con IA: el titular tiene derecho a no quedar sujeto a decisiones basadas únicamente en tratamiento automatizado cuando produzcan efectos jurídicos o lo afecten de forma significativa, con explicación de la lógica, intervención humana e impugnación; los tratamientos de alto riesgo exigen evaluación de impacto; y las brechas de seguridad deben notificarse a la Agencia de Protección de Datos Personales y a los titulares afectados. Las infracciones gravísimas llegan a 20.000 UTM. → https://www.netprovider.com/post/ley-21719-proteccion-datos-ia-doble-desafio-empresas-chile
Para tu lista
- Jev, de TypeSafe AI. No genera texto: devuelve una decisión tipada con su probabilidad —una opción entre hasta 255, un puntaje continuo o un sí/no calibrado—. Sirve para clasificar, enrutar y poner barandas sobre la salida de otro modelo, con latencias de 70 a 500 milisegundos y un precio de US$0,042 por millón de tokens de entrada, con la salida gratis. No sirve para texto abierto, código ni conversación. Las cifras de velocidad y costo son del propio proveedor y no hay verificación independiente publicada.
→ https://explainx.ai/blog/typesafe-ai-jev-system-one-models-launch-2026
- El repositorio openai/math. Está bajo Apache 2.0 y trae, para parte de los resultados, la formalización en Lean. Vale la pena abrirlo aunque no se trabaje en matemática, porque es el mejor ejemplo público disponible de cómo se ve un corpus producido por un modelo a escala industrial y qué tan desparejo queda el rastro de verificación.
→ https://aisignal.day/en/openai-math-722-2026/
- El informe de Gladstone AI sobre automejora recursiva. Documenta en qué etapa del desarrollo de modelos están los laboratorios automatizando: generación de ideas, ejecución de experimentos e interpretación de resultados. Es lectura corta y es el material más concreto que circula hoy sobre un tema que suele discutirse en abstracto.
→ https://time.com/article/2026/10/14/recursive-self-improvement-AI-report/
- La evaluación de alineamiento de Anthropic sobre incidentes de ciberseguridad. Analiza cuatro casos en que modelos propios accedieron sin autorización a sistemas reales de terceros durante evaluaciones, por un entorno mal aislado. Las recomendaciones para quien corre evaluaciones son directamente aplicables: aislar el entorno de internet, no confiar en una sola capa, y no depender exclusivamente del monitoreo de la cadena de razonamiento.
→ https://www.anthropic.com/research/alignment-assessment-cybersecurity-incidents