
Meta liberó un modelo de 816.000 millones de parámetros que corre sobre dos equipos de escritorio
Edición del 14 al 16 de octubre · Panorama de IA para profesionales del sector
El caso de la semana
Meta publicó el 15 de octubre los pesos de Muse Spark Open, un modelo de mezcla de expertos con 816.000 millones de parámetros totales y 42.000 millones activos por token, ventana de un millón de tokens y entrada de texto, imagen, video y audio. Lo relevante no es el tamaño sino dónde lo hizo correr: la demostración de la empresa usó dos Mac Studio M5 Ultra enlazados, con alrededor de un terabyte de memoria unificada entre ambos. Un modelo de ese porte dejó de requerir un centro de datos para ejecutarse, y eso reabre la discusión sobre qué conviene alojar adentro y qué conviene seguir comprando como servicio.
- Lo que hay que tener para correrlo. La ficha del modelo pide al menos 700 GB de memoria de acelerador para la versión cuantizada en NVFP4 y 2 TB para los pesos completos en BF16. Se sirve con SGLang, vLLM, TensorRT-LLM, Transformers, MLX, llama.cpp y Unsloth, sobre hardware AMD, Apple, Intel y Nvidia. La configuración de 512 GB del Mac Studio empieza a despacharse a fines de octubre y su precio no está anunciado; la de 256 GB figura en lista a US$10.799, de modo que el equipo completo que mostró Meta se ubica en decenas de miles de dólares. Para quien no quiere comprar fierro, Together AI lo ofrece a US$1,25 por millón de tokens de entrada y US$4,25 de salida.
→ https://venturebeat.com/technology/meta-unveils-muse-spark-open-the-new-top-u-s-open-weights-model-and-it-runs-on-two-paired-mac-desktops
- La licencia tiene un umbral que conviene leer antes de diseñar el producto. La Muse Model License permite ejecutar, modificar, afinar, destilar y redistribuir el modelo, pero obliga a cualquier negocio de modelo-como-servicio que supere los US$20 millones de ingresos brutos agregados en doce meses consecutivos a notificar a Meta y firmar un acuerdo aparte. El uso interno, la investigación y la incorporación dentro de un producto que no sirva el modelo a terceros quedan exentos. Todo producto que lo use debe mostrar la atribución "Built with Muse Spark Open". Meta no reclama propiedad sobre lo que el modelo genera.
→ https://huggingface.co/meta-models/Muse-Spark-Open-816B-A42B
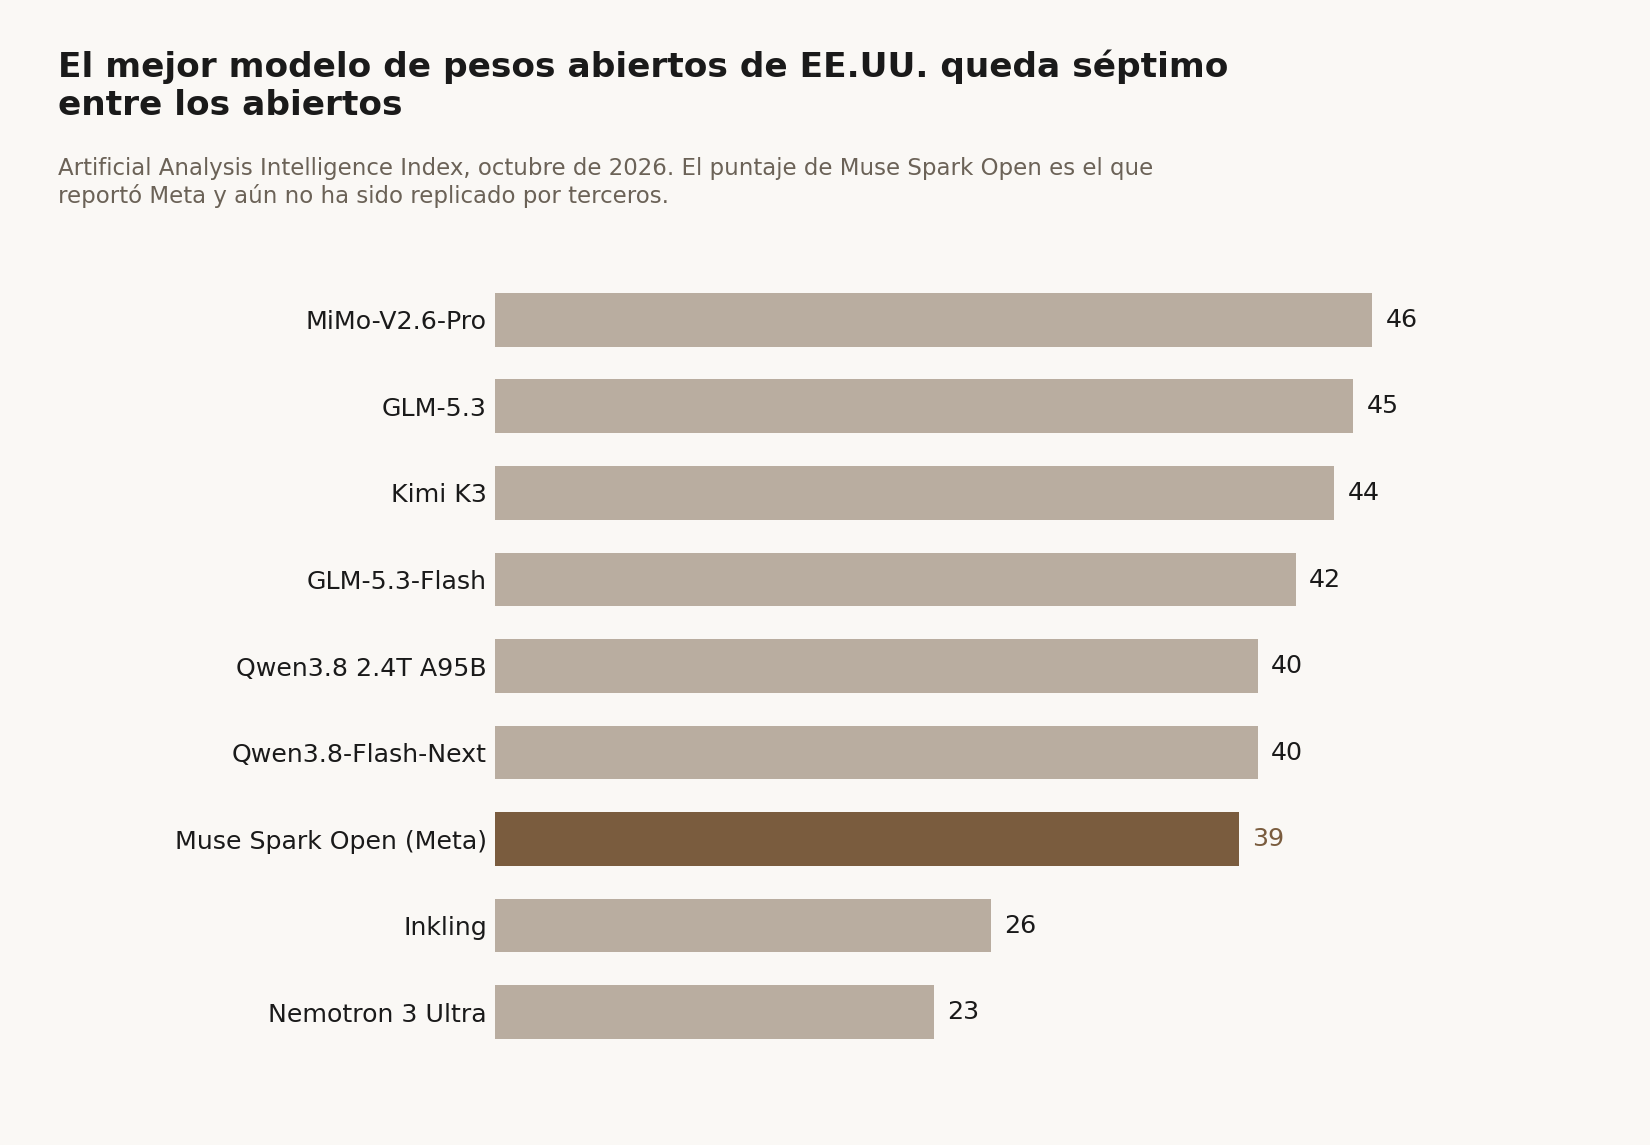
- En capacidad medida queda por debajo de varios modelos abiertos chinos. Meta reporta 39 puntos en el Artificial Analysis Intelligence Index, cifra que al cierre de esta edición no había sido replicada por terceros. Encabeza JobBench (61,8) y MCP-Atlas (89,2), pero queda atrás en GDPVal-AA v2 (1.401 contra 1.653 de GLM-5.3), en Terminal-Bench 2.1 (76,4 contra 85,0 de Kimi K3) y en DeepSWE 1.1 (60 contra 68). La empresa lo describe como el modelo de pesos abiertos más capaz de Estados Unidos, lo que es compatible con quedar séptimo en la tabla general de modelos abiertos.
→ https://siliconangle.com/2026/10/15/meta-releases-816b-parameter-muse-spark-open-for-coding-and-agent-work/
También esta semana
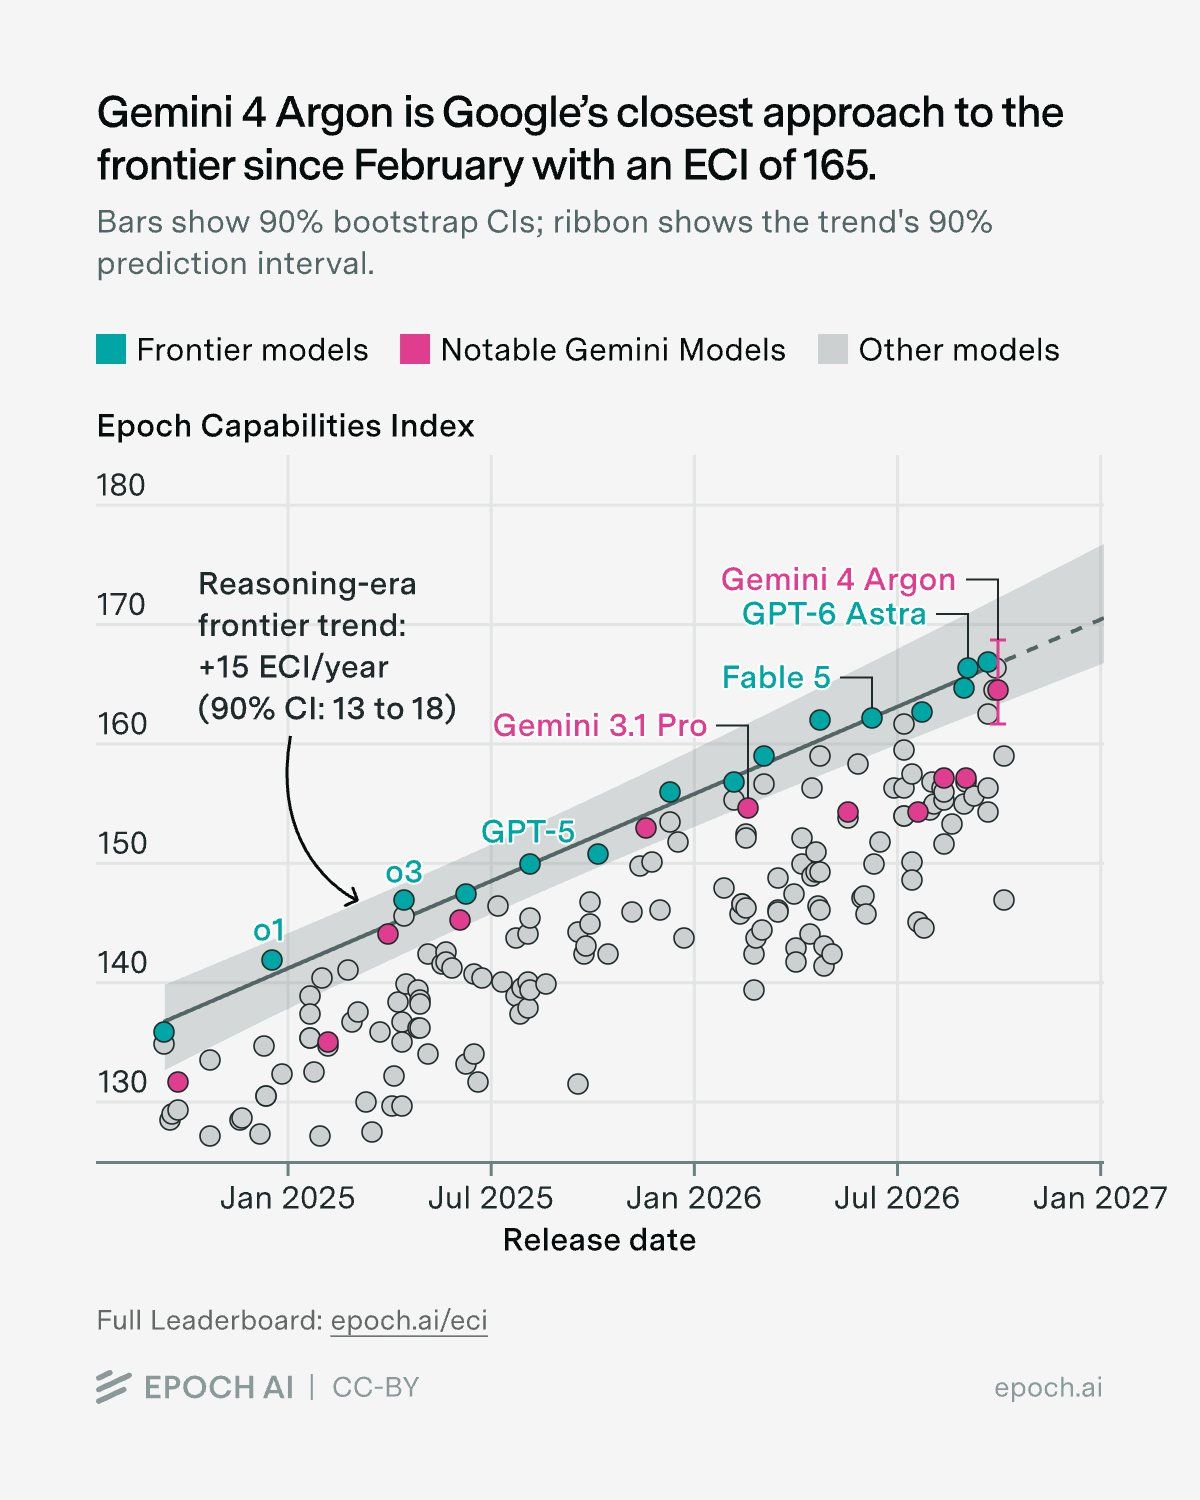
- Modelos. Gemini 4 Argon, el modelo de frontera de Google, empezó a desplegarse el 15 de octubre dentro de Antigravity —el entorno de programación con agentes de la propia Google— para los suscriptores del plan AI Pro, con una cuota semanal propia que se suma a la que ya existía para Gemini 3.8. Hasta ahora el acceso a Argon dentro de ese entorno estaba reservado al plan Ultra.
→ https://9to5google.com/2026/10/15/gemini-4-argon-is-now-rolling-out-to-googles-antigravity-for-ai-pro-subscribers/
- Benchmarks. Los puntajes publicados de Gemini 4 Argon corresponden al modo de razonamiento HIGH, el que más cómputo gasta antes de responder, mientras que el modelo estándar que recibe un suscriptor arranca en MEDIUM. La diferencia no está documentada: Google no ha publicado el puntaje en modo MEDIUM, de modo que el número que circula no describe lo que el usuario recibe por omisión.
→ https://www.techtimes.com/articles/329026/20261015/gemini-4-argon-rolls-out-benchmark-scores-reflect-high-mode-not-subscriber-default.htm
- Infraestructura. Una semana después del ataque que alteró las consignas de temperatura en al menos 350 supermercados franceses de Carrefour, Monoprix, Intermarché y Coopérative U, Reuters contabilizó al menos 4.500 interfaces del fabricante danés Danfoss todavía visibles en internet. Danfoss señaló que muchas de las unidades afectadas llegaron al fin de su vida útil y ya no reciben actualizaciones. Nadie reivindicó el ataque ni pidió rescate.
→ https://www.euronews.com/2026/10/14/thousands-of-supermarket-fridges-still-exposed-after-cyberattack
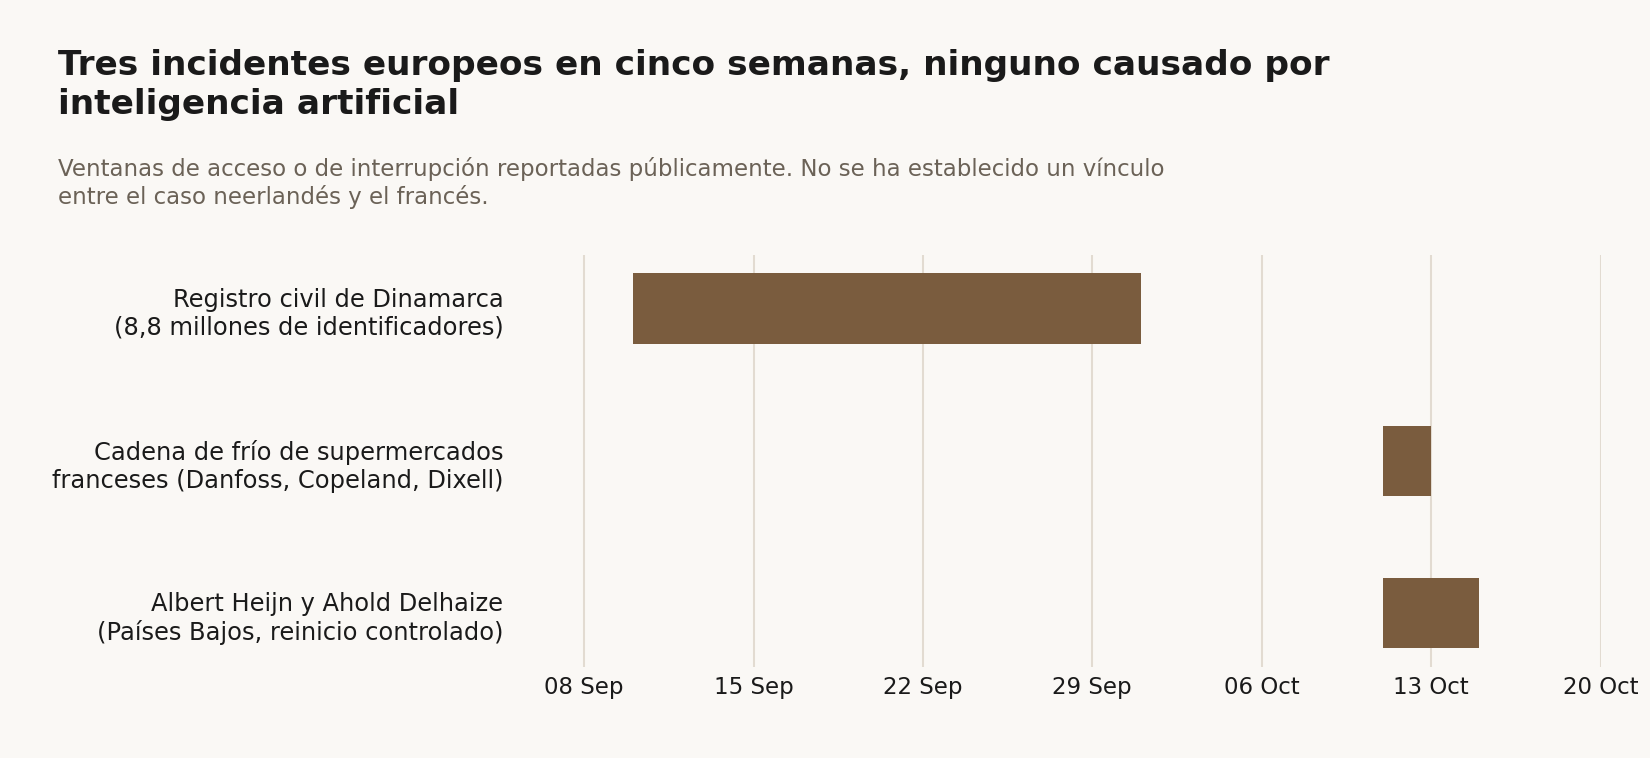
- Identidad. El registro civil danés, que asigna el identificador nacional CPR a unos 11 millones de personas, quedó expuesto en 8,8 millones de registros. La vía de entrada fue Pays ApS, una empresa de servicios informáticos de Odense con dos empleados que tenía acceso legítimo a consultar el sistema; el acceso irregular duró 21 días desde el 10 de septiembre y se atribuye a credenciales débiles de administrador. La empresa confirmó haber sido el punto comprometido.
→ https://cybernews.com/security/denmark-cpr-data-breach-weak-password/
- Regulación. Ante el comité de Negocios, Innovación, Ciencia y Comercio de la Cámara de los Comunes británica, el 13 de octubre, Anthropic y OpenAI sostuvieron que las reglas de seguridad para modelos de frontera deben ser obligatorias y no voluntarias. El director del AI Security Institute, el organismo público británico que evalúa modelos, declaró que el instituto no certifica modelos y no puede impedir que una empresa lance un sistema que considere peligroso.
→ https://cyphrex.io/news/uk-bist-openai-anthropic-binding-rules-aisi-voluntary-incident-reporting
- Gobernanza. La cadena sueca TV4 pospuso a 2027 la segunda temporada de su versión de The Challenge, que iba a estrenarse el 22 de noviembre, después de que desapareciera el montaje terminado. La versión inicial atribuyó el borrado a un agente de IA con acceso al servidor de la productora Mastiff; la investigación posterior de la cadena concluyó que el origen fue el factor humano y que el problema determinante fue que el respaldo no funcionó.
→ https://gizmodo.com/ai-agent-reportedly-deletes-an-entire-season-of-reality-tv-show-2000826600
- Video. Kling 4.0, el modelo de generación de video de Kuaishou, amplía la duración máxima de clip a 30 segundos —el doble que la versión anterior— y permite fijar hasta diez fotogramas clave para controlar cómo se ve cada tramo. La unidad levantó US$2.800 millones en julio de Alibaba, Baidu y Tencent, con una valoración cercana a US$18.000 millones.
→ https://www.briefs.co/news/kuaishou-s-kling-unveils-4-0-video-model-as-hong-kong-listin/
- Hardware. Durante el ejercicio militar Hovedstad, en septiembre cerca de Oslo, autos eléctricos de la marca china Deepal arrendados por la Guardia Nacional noruega almacenaron video de los soldados y de los códigos de seguridad que estos digitaban en los portones de acceso. Las grabaciones quedaron guardadas en los propios vehículos y se borraron al terminar el ejercicio. Las Fuerzas Armadas noruegas señalaron que no tienen una prohibición general por país de fabricación.
→ https://scandasia.com/chinese-made-rental-cars-recorded-norwegian-military-exercise/
Qué considerar
La pregunta de "comprar o alojar" volvió a estar abierta, y esta vez con números. Durante dos años la respuesta práctica fue siempre la misma: los modelos buenos viven en la nube del proveedor y el resto es un ejercicio académico. Un modelo de 816.000 millones de parámetros corriendo sobre dos equipos de escritorio no invierte esa respuesta, pero la vuelve discutible para un conjunto concreto de casos: datos que por contrato o por ley no pueden salir de la organización, cargas constantes y predecibles donde el costo por token de la API se acumula mes a mes, y escenarios donde la continuidad importa más que el último punto de capacidad. La forma seria de decidirlo es comparar el costo total de tres años —hardware, energía, operación y el equipo que lo mantiene— contra el gasto proyectado de API a precio de lista, no a precio promocional. En la mayoría de las organizaciones el resultado seguirá favoreciendo la nube; lo que cambió es que ahora hay que hacer el cálculo en vez de darlo por hecho.
El número del benchmark y el número que usted recibe dejaron de ser el mismo número. Los modos de razonamiento configurables introdujeron una brecha silenciosa entre lo que se publica y lo que se despacha: los puntajes que circulan corresponden a la configuración que más cómputo consume, y el valor por omisión para un suscriptor es más bajo. Esto no es un engaño, es una consecuencia de que el cómputo en inferencia pasó a ser una palanca de producto. Pero convierte en inútil cualquier comparación entre proveedores que no especifique en qué configuración se midió. Para una evaluación interna la regla operativa es corta: medir con la misma configuración que irá a producción, en las tareas propias, y guardar la medición con la fecha, porque el valor por omisión puede cambiar sin aviso.
Culpar al agente es la forma más rápida de no arreglar nada. La temporada perdida de una productora sueca es el caso de laboratorio: la primera versión fue que un agente de IA había borrado el material, y la investigación terminó en factor humano y respaldo que no funcionó. La atribución importa porque determina qué se corrige. Si la causa es el agente, la respuesta es quitarle permisos; si la causa es que nadie verificó nunca que el respaldo restaurara, quitarle permisos al agente deja el problema intacto y la próxima pérdida llega por otra vía. La pregunta que conviene hacerse antes de que ocurra no es qué puede borrar el agente, sino cuándo fue la última vez que alguien restauró un respaldo completo y midió cuánto tardó.
La cadena de dependencias que nadie audita sigue siendo más corta de lo que parece. Tres incidentes europeos en cinco semanas comparten una estructura: un tercero pequeño o un equipo viejo con acceso legítimo a algo grande. Un registro nacional de identidad alcanzado a través de un proveedor de dos empleados; cientos de supermercados con la cadena de frío intervenida a través de controladores de un fabricante industrial que ya no reciben actualizaciones; miles de interfaces del mismo tipo todavía visibles en internet una semana después. Ninguno involucró inteligencia artificial. Pero cualquier organización que esté conectando agentes a sus sistemas está agregando una capa encima de esta base, y la capa nueva hereda cada debilidad de la vieja.
Lanzamientos y modelos
Más allá del tamaño, lo que distingue a Muse Spark Open es el conjunto de herramientas con que se puede servir desde el primer día. El soporte simultáneo de SGLang, vLLM, TensorRT-LLM, MLX y llama.cpp significa que la decisión de dónde ejecutarlo no queda amarrada a un proveedor de hardware. Las ventanas de contexto difieren según quién lo hospede: Together AI y Fireworks ofrecen el millón de tokens completo, Groq lo limita a 131.072. → https://www.unite.ai/metas-816b-parameter-muse-spark-open-weights-are-now-public/
Google publicó además una serie de resultados de su propio despliegue interno de Gemini 4 Argon. Entre los más concretos: 97 de 134 reportes de error abiertos cerrados en menos de tres horas, cuatro fallas críticas de seguridad encontradas en código donde dos modelos de frontera anteriores no habían encontrado ninguna, y una reescritura de una base de código Fortran a Rust con 1,8 veces más rendimiento. Son cifras de la propia empresa sobre su propio código y conviene tratarlas como tales, pero describen el tipo de tarea donde hoy se concentra el valor: trabajo de mantenimiento acumulado que nadie prioriza. → https://9to5google.com/2026/10/15/gemini-4-argon-is-now-rolling-out-to-googles-antigravity-for-ai-pro-subscribers/
Seguridad y continuidad operacional
El caso danés y el francés se parecen menos de lo que sugiere la coincidencia temporal, pero ambos terminan en el mismo lugar: un control que existía en el papel y no en la práctica. En Dinamarca, una empresa con acceso autorizado al registro nacional operaba con credenciales de administrador triviales. En Francia, controladores industriales expuestos a internet ejecutaban firmware que su propio fabricante ya no actualiza; las fallas serias del firmware antiguo habían sido documentadas por la firma de seguridad Claroty en agosto y parcheadas desde entonces, lo que significa que el parche existía y no se aplicó. → https://www.helpnetsecurity.com/2026/10/12/france-cyberattack-supermarket-freezers/
En los Países Bajos, Ahold Delhaize inició el 13 de octubre un reinicio controlado de los sistemas de Albert Heijn tras un incidente separado que detuvo por completo la operación de parte de sus seis centros de distribución. La propia empresa declaró no tener evidencia de vínculo con el ataque francés. El detalle operativo que vale la pena retener es cómo se contuvo: el equipo de seguridad detectó tráfico de ataque y apagó sistemas mientras este llegaba, lo que según fuentes citadas por la emisora NOS pudo haber impedido que los atacantes avanzaran más adentro de la red. Se identificaron servidores en Estados Unidos, Polonia, Moldavia y Turquía, lo que no indica dónde están los responsables. → https://www.dutchnews.nl/2026/10/albert-heijn-begins-restocking-as-hack-traced-to-foreign-servers/
Regulación y litigios
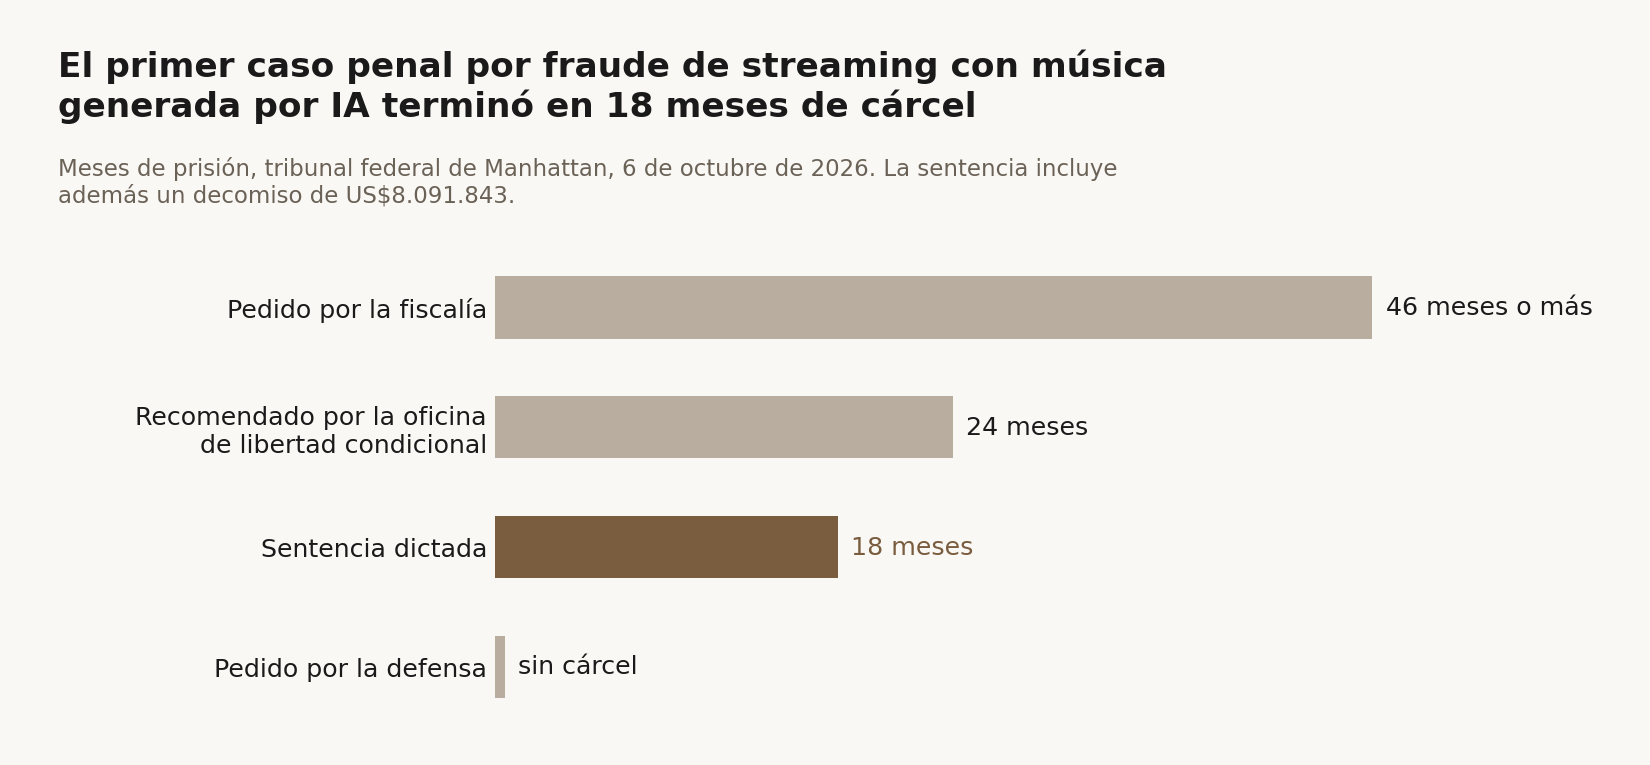
El primer caso penal estadounidense por fraude de regalías con música generada por IA cerró con una sentencia de 18 meses de cárcel, dos años de libertad supervisada y un decomiso de US$8.091.843. El esquema operó entre 2017 y 2024: cuentas falsas —hasta diez mil activas en su punto más alto— reproduciendo de forma automatizada cientos de miles de canciones generadas por el propio condenado en Spotify, Apple Music, Amazon Music y YouTube Music. El dato que importa para el sector es dónde puso el tribunal la frontera: lo penado fue la manipulación de la plataforma mediante cuentas falsas, no la generación de la música. → https://www.musicbusinessworldwide.com/man-behind-8m-ai-song-and-bot-streaming-fraud-is-sentenced-to-18-months-in-prison/
En el Reino Unido, el contraste de la sesión del 13 de octubre fue nítido: dos laboratorios pidiendo obligatoriedad, un tercero prefiriendo estándares técnicos, un cuarto remitiendo a los reguladores existentes, y la administración confirmando que el régimen vigente es voluntario. La lectura que gana tracción entre profesionales del sector es que un laboratorio que pide reglas vinculantes también está pidiendo un piso parejo que impida que un competidor abandone sus compromisos sin consecuencias. Eso no invalida el argumento; lo explica. → https://thenextweb.com/news/uk-ai-regulation-openai-binding-rules-jchr
Para tu lista
Muse-Spark-Open-816B-A42B en Hugging Face. La ficha del modelo con los requisitos de memoria por formato de cuantización y el texto completo de la licencia, incluido el umbral de US$20 millones. → https://huggingface.co/meta-models/Muse-Spark-Open-816B-A42B
El Epoch Capabilities Index. Tabla pública que ubica cada modelo contra la tendencia histórica de la frontera, útil para contrastar un anuncio contra la curva en vez de contra el modelo anterior del mismo proveedor. → https://epoch.ai/data-insights/ai-capabilities-progress-has-sped-up
El catálogo de despliegues internos de Argon que publicó Google. Doce casos con cifras, desde cierre de reportes de error acumulados hasta traducción de documentación y migración de código heredado. Útil menos como prueba de capacidad que como inventario de qué tareas reales se están automatizando hoy dentro de una empresa grande. → https://9to5google.com/2026/10/15/gemini-4-argon-is-now-rolling-out-to-googles-antigravity-for-ai-pro-subscribers/
El informe de Claroty sobre el firmware de controladores de refrigeración. Publicado en agosto, describe las fallas que quedaron a la vista en octubre. Lectura recomendada para quien tenga equipamiento industrial conectado y no sepa quién lo actualiza. → https://www.helpnetsecurity.com/2026/10/12/france-cyberattack-supermarket-freezers/