Un recorte de 90% en la nube y un modelo de 137B en el escritorio, el mismo día
Edición del 7 al 8 de octubre · Panorama de IA para profesionales del sector
El caso de la semana
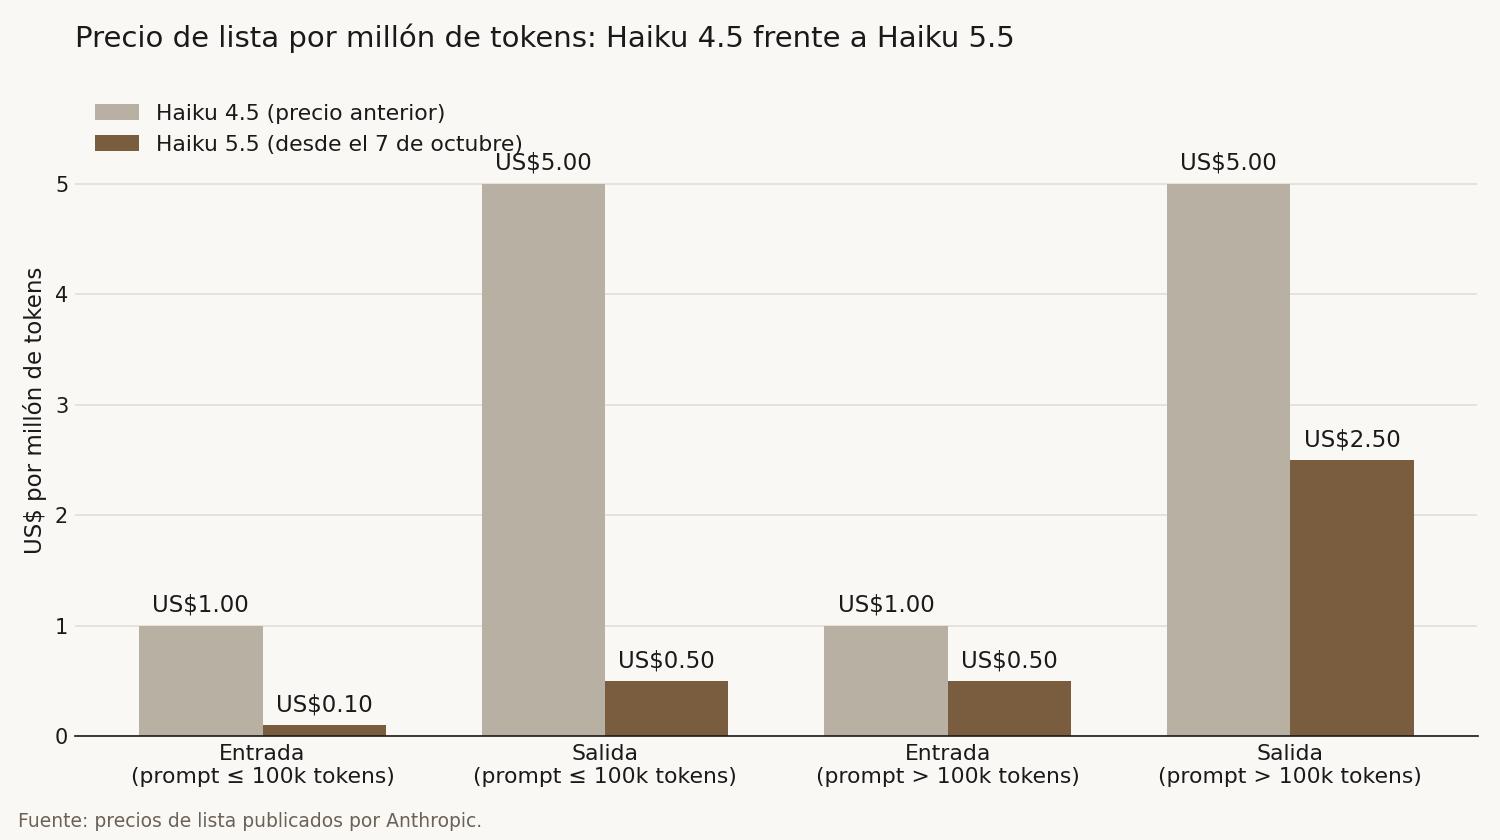
El martes 7 de octubre Anthropic y Microsoft movieron la misma variable desde extremos opuestos: el costo de correr un modelo capaz. Uno bajó el precio de lista casi un orden de magnitud; el otro sacó el modelo del centro de datos y lo puso a correr en un portátil. El efecto combinado es que el costo por token dejó de ser el único eje de la decisión de arquitectura.
- La ruta de la nube: diez veces más barato por el mismo trabajo. Anthropic lanzó Claude Haiku 5.5 a US$0,10 por millón de tokens de entrada y US$0,50 de salida para prompts de hasta 100.000 tokens, contra US$1 y US$5 de Haiku 4.5. Por sobre ese umbral la tarifa sube a US$0,50 y US$2,50. La ventana de contexto pasa de 200.000 a 1 millón de tokens y la salida máxima de 64.000 a 128.000. Está disponible en la API de Claude, Amazon Bedrock, Google Cloud y Microsoft Foundry.
→ https://www.anthropic.com/news/claude-haiku-5-5
- El salto de capacidad es real, y el punto de comparación importa. En las cifras del propio fabricante, Haiku 5.5 sube de 15,7% a 72,4% en OSWorld 2.1 —una prueba de manejo autónomo del computador—, de 10,2% a 45,9% en Humanity's Last Exam sin herramientas y de 0% a 39,2% en Terminal-Bench 4.0, que mide tareas completas en línea de comandos. Supera a GPT-6 Luna en todas las filas publicadas y queda por debajo de Sonnet 5.5 en todas ellas: es el modelo pequeño que se volvió utilizable, no el modelo de frontera que se abarató. Ninguna cifra tiene reproducción independiente todavía.
→ https://www.anthropic.com/news/claude-haiku-5-5
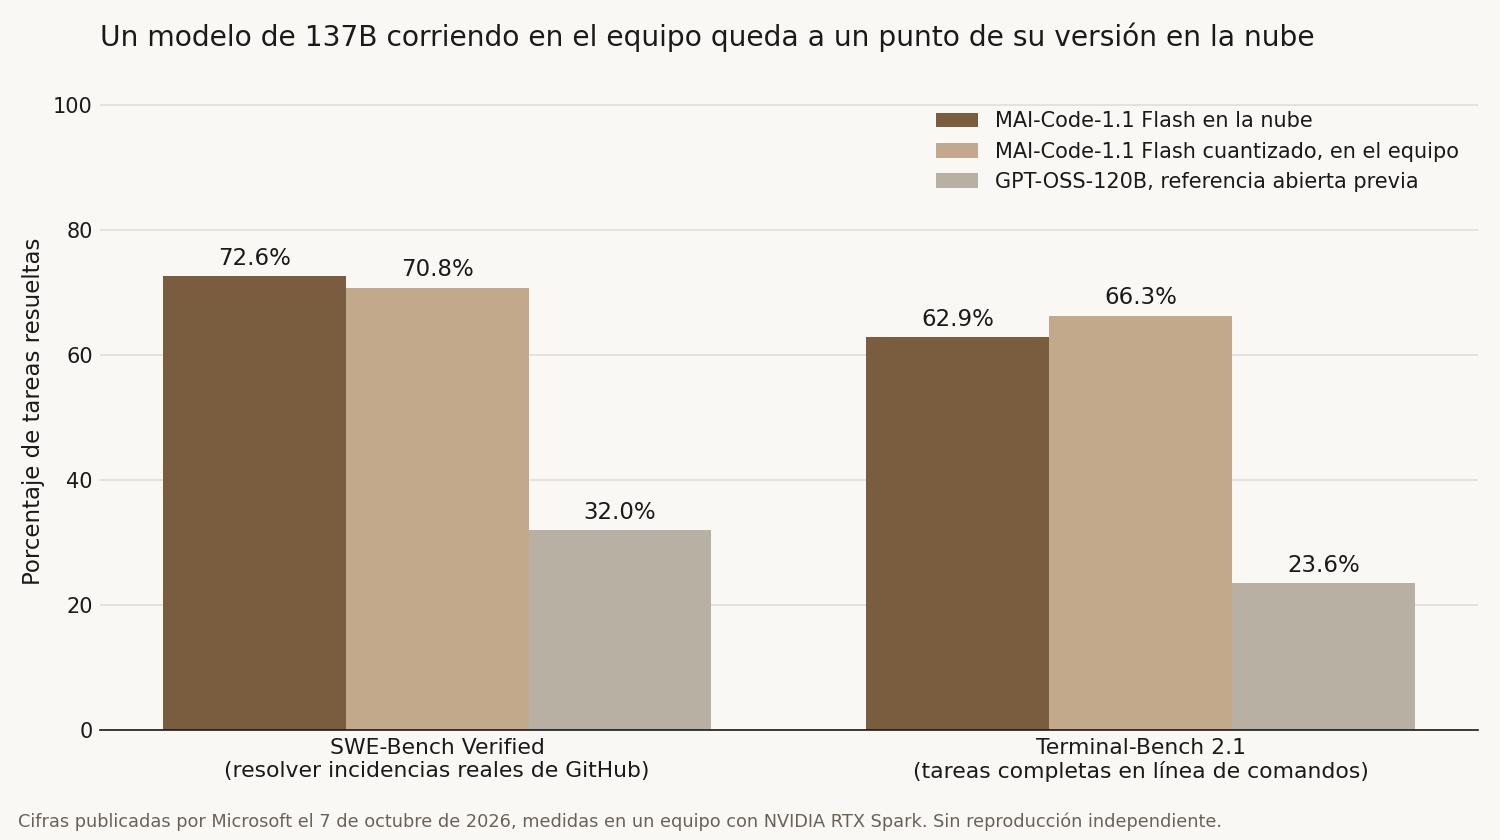
- La ruta del escritorio: 137.000 millones de parámetros corriendo en un portátil. Microsoft publicó el mismo día la versión local de MAI-Code-1.1 Flash, un modelo de programación con arquitectura de mezcla de expertos —activa solo una fracción de sus parámetros en cada paso— de 137.000 millones de parámetros totales y 6.800 millones activos. Cuantizado —comprimido a unos 3,3 bits por parámetro, a cambio de algo de precisión— ocupa 53 GB en disco y llega a un pico de 75,5 GB de memoria con contexto de 256.000 tokens. Resuelve 70,8% de SWE-Bench Verified, una prueba estándar que mide cuántas incidencias reales de proyectos de software en GitHub logra arreglar, contra 72,6% de su versión en la nube.
→ https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/
También esta semana
- Verificación. Tres matemáticos —Alexander Bastounis, Fabian Circelli y Anders Hansen— publicaron el 6 de octubre un artículo que muestra que la prueba de Navier-Stokes anunciada por OpenAI el mes pasado no coincide con su propia formalización en el asistente de demostración Lean. En el Lema 8.6 el texto en lenguaje natural pide una cota con cuatro derivadas adicionales y el código en Lean formaliza una con cinco, que es estrictamente más débil. Los autores no afirman que la prueba escrita sea incorrecta; afirman que lo verificado por la máquina no es lo que el texto enuncia.
→ https://arxiv.org/abs/2610.08144
- Gobernanza. La Novena Sala de la Corte de Apelaciones de Santiago firmó el 6 de octubre una sentencia en un juicio ejecutivo por cobro de pagaré en la que quedó incorporada al expediente la instrucción usada para generarla, que pedía al sistema actuar como juez y redactar la parte considerativa "rechazando/acogiendo" el recurso. La sala pidió un informe al relator en 24 horas y dictó una rectificación. El Poder Judicial chileno no tiene hoy normativa propia sobre uso de IA en la redacción de fallos.
→ https://www.biobiochile.cl/noticias/nacional/chile/2026/10/07/escandalo-en-tribunales-corte-dejo-al-descubierto-que-uso-ia-y-se-le-colaron-hasta-las-instrucciones.shtml
- Agentes. Meta y Sierra anunciaron el 6 de octubre el Personal Agent Protocol, un estándar abierto para que los asistentes personales se conecten directamente con las empresas en vez de navegar sus sitios web como lo haría una persona. Define descubrimiento del servicio desde el sitio de la empresa, sesión basada en OAuth que se mantiene entre canales y permisos diferenciados de solo lectura o de escritura. Participan Shopify, Stripe, Walmart, Genesys y Rocket; la especificación v0.1 se publicaría a fines de octubre.
→ https://sierra.ai/blog/introducing-personal-agent-protocol
- Mercado. Tab, un asistente personal que se opera por mensajes de texto desde iMessage o WhatsApp, salió del modo sigiloso el 7 de octubre con una valuación de US$300 millones y respaldo de SV Angel, Valar Ventures y American Spirit. Tiene número de teléfono, computador y billetera propios para gestionar compras, reservas y trámites. La empresa declara que no usa los datos del usuario para entrenar, que la tarjeta queda en una bóveda a la que el agente no accede y que ninguna acción irreversible se ejecuta sin aprobación.
→ https://techcrunch.com/2026/10/07/another-personal-ai-assistant-has-launched-meet-tab-which-emerged-from-stealth-with-a-300m-valuation/
- Privacidad. Google publicó el 8 de octubre AI Edge Foresight, una aplicación para Mac que transcribe reuniones, genera notas y responde preguntas sobre ellas ejecutando los modelos en el propio equipo: EmbeddingGemma 2, de 740 millones de parámetros, para capturar las notas, y Gemma 4 para el asistente. Según el material de Google puede funcionar completamente sin conexión, incluso en reuniones presenciales, y admite subir PDF, documentos de Office y Markdown como base de conocimiento.
→ https://techcrunch.com/2026/10/08/google-releases-a-new-local-first-granola-competitor/
- Aislamiento. Junto con los modelos locales, Microsoft liberó como código abierto MXC, una biblioteca que traduce una política de permisos a controles nativos del sistema operativo —BaseContainer en Windows, Seatbelt en macOS, bubblewrap en Linux— sin necesidad de máquina virtual ni imagen de contenedor. Es la pieza que acota qué archivos, red y credenciales puede tocar un agente de programación, independientemente de qué modelo pidió la tarea.
→ https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/
- Programas. Claude for Startups ofrece hasta US$45.000 en créditos y descuentos de terceros canjeables en la consola de Anthropic, sesiones quincenales con su equipo de IA aplicada y, para startups cuyo fondo pertenezca a la red de socios, hasta US$100.000 en créditos de API reclamados a través del fondo. Está abierto a empresas sin financiamiento de riesgo. La oferta de un año gratis de Claude Team está sobredemandada y Anthropic declara que está revisando de nuevo todas las solicitudes.
→ https://claude.com/programs/startups
Qué considerar
El ruteo entre local y nube es una decisión de arquitectura, no una preferencia. Lo que cambió el martes no es que exista inferencia local —existe hace años— sino que un modelo local entrega 70,8% en SWE-Bench Verified frente a 72,6% de su gemelo en la nube, y que GitHub Copilot va a repartir las tareas entre ambos de forma automática a fines de octubre. Esa diferencia de menos de dos puntos convierte en decisión económica lo que antes era una concesión de calidad. La pregunta útil para un equipo es cuáles de sus cargas toleran latencia variable y requieren que el código no salga del equipo, y cuáles necesitan el modelo más capaz disponible: la primera categoría tiene ahora costo marginal cercano a cero después de comprar el fierro, y la segunda no. Conviene además leer la letra chica: correr el modelo localmente no significa que la sesión funcione sin conexión, y el hardware de referencia parte en equipos con hasta 128 GB de memoria unificada.
Una verificación que pasa no verifica necesariamente lo que creías. El hallazgo sobre la prueba de Navier-Stokes es el caso más limpio de un problema que aparece en cualquier flujo asistido: la traducción entre lo que se quiso decir y lo que la máquina comprobó. Lean hizo su trabajo sin errores; lo que falló fue la traducción desde el texto, y el resultado es un certificado válido de una afirmación más débil que la enunciada. La lectura que gana tracción entre quienes trabajan con verificación formal es que el certificado solo vale si alguien revisó que el enunciado formalizado sea el enunciado que importa. Traducido a software: una batería de pruebas verde prueba que el código cumple las pruebas, no que cumpla el requisito, y cuando las pruebas también las escribió el modelo a partir del mismo texto ambiguo, el riesgo no es que fallen sino que confirmen la lectura equivocada. El paso que no se puede delegar es la revisión del criterio de aceptación, no la de la implementación.
El prompt es parte del expediente. El episodio de la Corte de Apelaciones no es una anécdota sobre descuido: es la demostración de que el material intermedio de un flujo asistido tiende a filtrarse al entregable final, y de que cuando el entregable es un acto con efectos jurídicos el costo de esa filtración recae sobre la institución, no sobre la herramienta. La objeción más extendida entre profesionales es que el problema fue el prompt —pedirle al modelo que redacte una conclusión predefinida—, y es cierto, pero es la parte menos transferible del caso. Lo que sí se transfiere a cualquier organización es la pregunta de gobernanza: si mañana apareciera dentro de un documento firmado el texto exacto de la instrucción que lo generó, ¿habría una política que diga quién podía usar el asistente, para qué parte del documento y con qué revisión previa? En la mayoría de las organizaciones hoy la respuesta es que no, y la brecha se cierra con una norma de una página, no con un proyecto.
El canal entre agentes y empresas se está definiendo ahora, y conviene estar en la conversación. Hasta esta semana el asistente personal que compra, reserva o reclama por el usuario lo hacía simulando ser una persona en un sitio web. El Personal Agent Protocol propone reemplazar esa simulación por una conexión declarada, con autenticación, permisos y trazabilidad. Para cualquier empresa que atienda clientes finales eso plantea una decisión que no es técnica: si no se expone un canal explícito, los agentes van a seguir entrando por el formulario y por el chat de soporte, sin identificarse y sin límites de tasa; si se expone, hay que definir qué puede hacer un agente sin intervención humana y cómo se registra. Vale la pena revisar la especificación cuando se publique, aunque la decisión de adoptarla se tome después.
Lanzamientos y productos
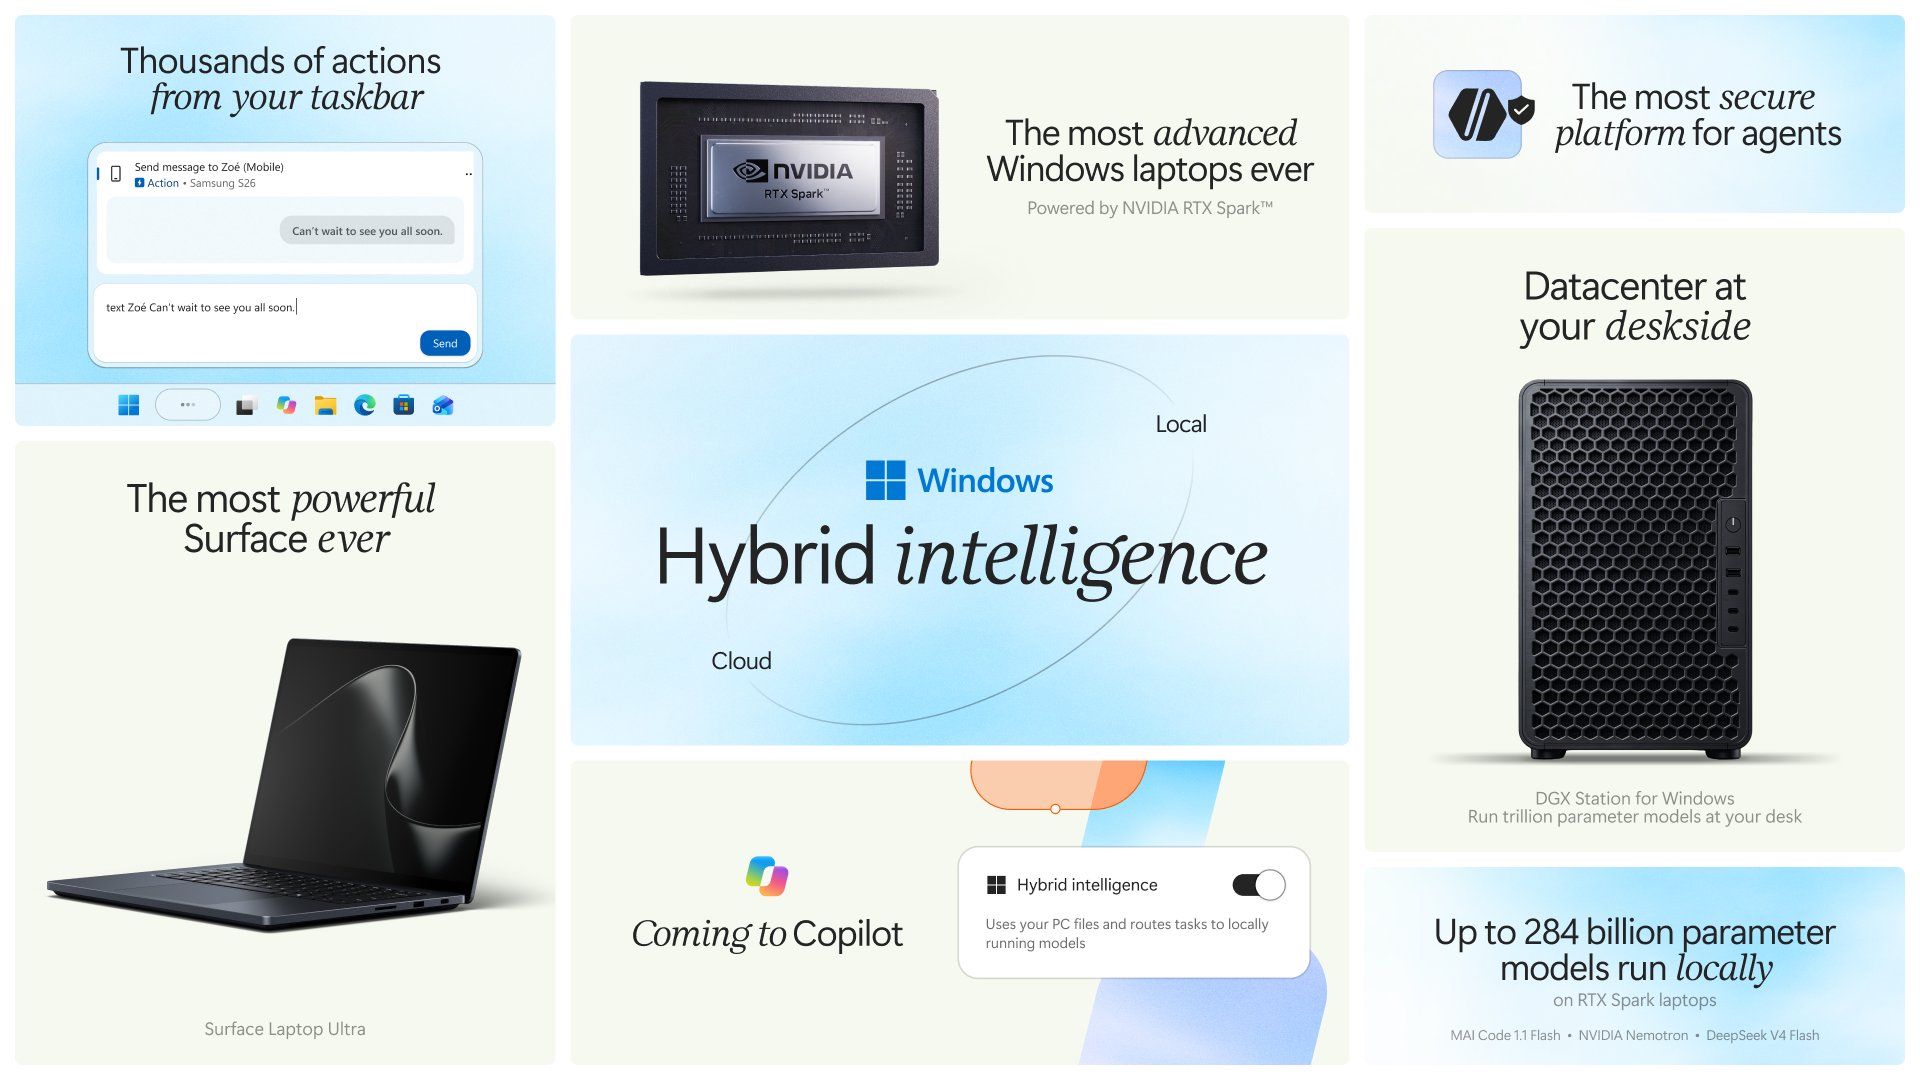
- Microsoft presentó Windows con "inteligencia híbrida": modelos ejecutándose en el equipo y en la nube con ruteo automático desde Copilot, acciones disponibles desde la barra de tareas y hardware de referencia basado en NVIDIA RTX Spark, incluido el Surface Laptop Ultra y una estación DGX de escritorio. El material de la compañía menciona modelos de hasta 284.000 millones de parámetros corriendo localmente en portátiles con ese chip.
→ https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/
- El ruteo automático entre modelo local y modelo en la nube llega a GitHub Copilot a fines de octubre, en la línea de comandos, la aplicación y VS Code, con modo automático que considera el contexto de la tarea y el estado de la caché, y con selección manual de un modelo local vía Windows ML o un endpoint compatible con la API de OpenAI.
→ https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/
Movimientos de industria
- La categoría de asistente personal se pobló en semanas: Muse de Meta, disponible por ahora solo en Estados Unidos y Canadá; Tab, que salió del sigilo el 7 de octubre con valuación de US$300 millones; y los asistentes con máquina virtual propia y navegador que ya operan de forma continua por cuenta del usuario. El patrón común no es el modelo que usan sino lo que administran: una identidad, un medio de pago y un canal de mensajería.
→ https://techcrunch.com/2026/10/07/another-personal-ai-assistant-has-launched-meet-tab-which-emerged-from-stealth-with-a-300m-valuation/
- El lugar donde se decide la competencia entre esos asistentes se está desplazando del modelo al perímetro: qué puede tocar el agente, con qué credenciales y con qué registro. Tanto el protocolo anunciado por Meta y Sierra como la biblioteca de aislamiento liberada por Microsoft apuntan a la misma capa, desde el lado de la empresa y desde el lado del sistema operativo respectivamente.
→ https://sierra.ai/blog/introducing-personal-agent-protocol
Regulación y litigios
- El caso de la Corte de Apelaciones de Santiago llega a un vacío normativo: la Academia Judicial reconoce el potencial de estas herramientas pero advierte sobre transparencia y sesgos, y el Colegio de Abogados publicó en julio de 2026 una guía de recomendaciones para el ejercicio profesional. Ninguno de los dos instrumentos es vinculante para la redacción de sentencias.
→ https://www.biobiochile.cl/noticias/nacional/chile/2026/10/07/escandalo-en-tribunales-corte-dejo-al-descubierto-que-uso-ia-y-se-le-colaron-hasta-las-instrucciones.shtml
- En el plano académico, un grupo autodenominado Association for Human Mathematics publicó una declaración pidiendo a los matemáticos dejar de colaborar con OpenAI tras la publicación masiva de manuscritos generados por modelo. El texto está firmado por un grupo de trabajo, sin firmantes individuales identificados, y no representa a ninguna sociedad matemática establecida; la discusión de fondo que abre —qué estatus tiene un resultado que nadie alcanzó a revisar— sí está instalada en la disciplina.
→ https://www.ahmath.org/statements
Para tu lista
walkinglabs/learn-harness-engineering, un curso práctico y gratuito, licencia MIT, sobre construir el andamiaje alrededor de un agente de programación: instrucciones persistentes, estado en disco entre sesiones, verificación automática, alcance acotado y ciclo de vida de la sesión. Catorce lecciones y ocho proyectos sobre una aplicación real, más plantillas y un script de auditoría. Es la contraparte concreta de la discusión sobre verificación de esta edición.
→ https://github.com/walkinglabs/learn-harness-engineering
- MXC, la biblioteca de aislamiento de Microsoft, si te interesa correr agentes con permisos acotados sin montar contenedores. Vale la pena mirarla aunque no uses Copilot: la política se expresa una vez y se traduce a los controles nativos de Windows, macOS y Linux.
→ https://commandline.microsoft.com/local-models-sandboxed-tools-github-windows/
- AI Edge Foresight, para equipos que no pueden mandar el audio de sus reuniones a un servicio externo. Es una alternativa local a las herramientas de notas asistidas, con los modelos corriendo en el Mac.
→ https://techcrunch.com/2026/10/08/google-releases-a-new-local-first-granola-competitor/
- "Navier-Stokes lost in translation", el artículo sobre la brecha entre prueba escrita y prueba formalizada. Las secciones iniciales se leen sin saber análisis: el argumento sobre por qué una traducción semánticamente fiel no puede garantizarse en general aplica a cualquier flujo donde un modelo traduce un requisito a una comprobación.
→ https://arxiv.org/abs/2610.08144