OpenAI publicó 722 demostraciones matemáticas que nadie alcanzó a revisar
Edición del 5 al 7 de octubre · Panorama de IA para profesionales del sector
El caso de la semana
Entre el 5 y el 6 de octubre OpenAI subió a un repositorio público 722 manuscritos de matemática pura generados por un modelo interno que no ha publicado, y le pidió a la comunidad matemática que los revise. El episodio importa menos por los teoremas que por lo que revela: la producción de conocimiento experto dejó de ser el cuello de botella, y la verificación pasó a serlo.
- Qué se publicó y a qué ritmo. El repositorio
openai/math, con licencia Apache 2.0, contiene 722 manuscritos agrupados en 372 familias de problemas, donde cada familia reúne el resultado principal, argumentos complementarios y demostraciones alternativas. Según la propia documentación, el modelo evaluó cerca de 4.000 problemas de investigación y cada resultado consumió en promedio tres horas de cómputo de razonamiento del nivel ChatGPT Pro. El conjunto abordaría alrededor de 90 de los 500 problemas abiertos más conocidos de la disciplina.
→ https://github.com/openai/math
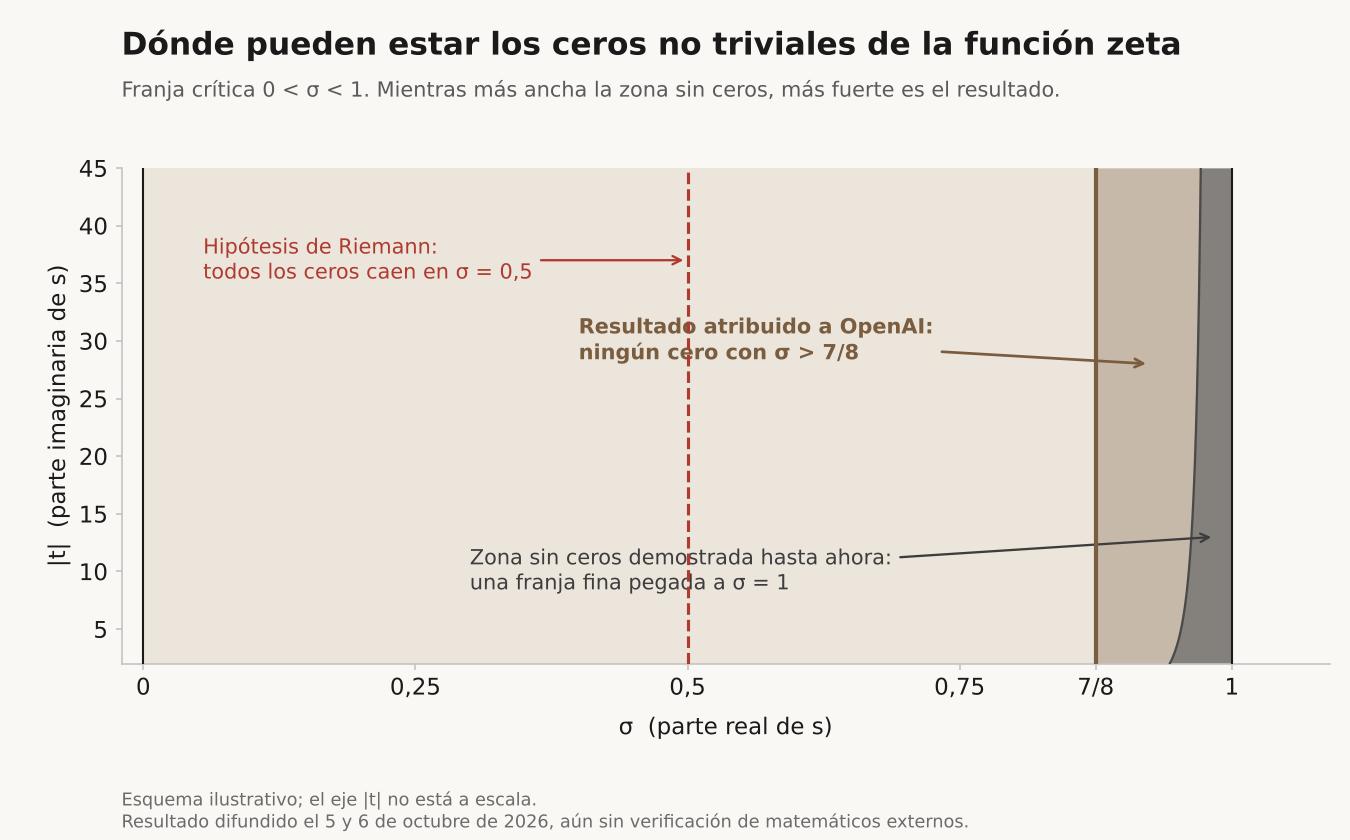
- El resultado más citado es un avance parcial sobre el problema abierto más famoso de la matemática. Se lo apoda hipótesis cuasi-Riemann: afirma que ningún cero no trivial de la función zeta de Riemann tiene parte real por encima de 7/8, lo que confinaría todos esos ceros a la banda entre 1/8 y 7/8. No es la hipótesis de Riemann, que exige que todos caigan exactamente en 1/2, pero sería un salto enorme respecto de lo demostrado hasta ahora, que solo descarta ceros en una franja muy delgada pegada al borde de la banda.
→ https://officechai.com/ai/openai-releases-ai-generated-proofs-of-quasi-riemann-hypothesis-unique-games-conjecture-hodge-conjecture-for-cm-abelian-varieties/
- Tres de los cuatro resultados destacados traen demostración formal en Lean; el resto del lote, no necesariamente. Lean es un asistente de demostración: un programa que revisa paso a paso la lógica de una prueba y solo la acepta si cada inferencia se deriva de axiomas y resultados ya aceptados. Tenerla significa que la lógica está mecánicamente comprobada, no que el enunciado sea interesante ni que esté bien formulado. El propio repositorio advierte que no todos los manuscritos están formalizados y que algunos de los no formalizados "podrían tener problemas". Ningún resultado ha sido validado todavía por matemáticos externos.
→ https://github.com/openai/math
También esta semana
- Procedencia. OpenAI anunció el 5 de octubre textGrain, una marca de agua para texto: una señal estadística invisible incrustada en la elección de palabras del modelo, que un detector puede reconocer después. Llega a ChatGPT y Codex en la Unión Europea en las próximas semanas, empujada por el reglamento europeo de IA, y queda disponible como opción voluntaria en la API en todo el mundo desde ya. El detector no es público: hay que postular y está reservado a investigadores y organizaciones aprobadas.
→ https://openai.com/index/eu-text-provenance/
- Propiedad intelectual. Qualcomm pagará a Huawei por licenciar sus patentes por primera vez desde que ambas firmaron su primer acuerdo, hace 25 años, cuando el flujo iba en sentido contrario. El acuerdo anunciado el 6 de octubre es multianual y cubre patentes de 5G, inteligencia artificial, cómputo y redes; Qualcomm además comprará parte de la cartera estadounidense de Huawei, sujeto a aprobación regulatoria. Huawei declara 165.000 patentes activas concedidas en el mundo y US$6.900 millones acumulados en acuerdos de licenciamiento.
→ https://www.tomshardware.com/tech-industry/semiconductors/qualcomm-will-pay-huawei-to-license-its-patents-for-the-first-time-in-historic-turnaround-reversal-in-a-5g-and-ai-cross-licensing-deal-comes-25-years-after-huawei-first-paid-qualcomm
- Formatos. Google habilitó el 5 de octubre la edición nativa de archivos Markdown —el formato de texto plano con marcas simples como asteriscos y almohadillas— en Google Docs, y la vista previa renderizada en Drive, sin convertir el archivo ni perder comentarios. Está disponible para todos los clientes de Workspace y también para cuentas personales. En el anuncio Google explicita el motivo: Markdown es el formato que usan los modelos de lenguaje para preservar contenido estructurado.
→ https://workspaceupdates.googleblog.com/2026/10/preview-edit-and-collaborate-on-Markdown-files-natively-across-Drive-and-Docs.html
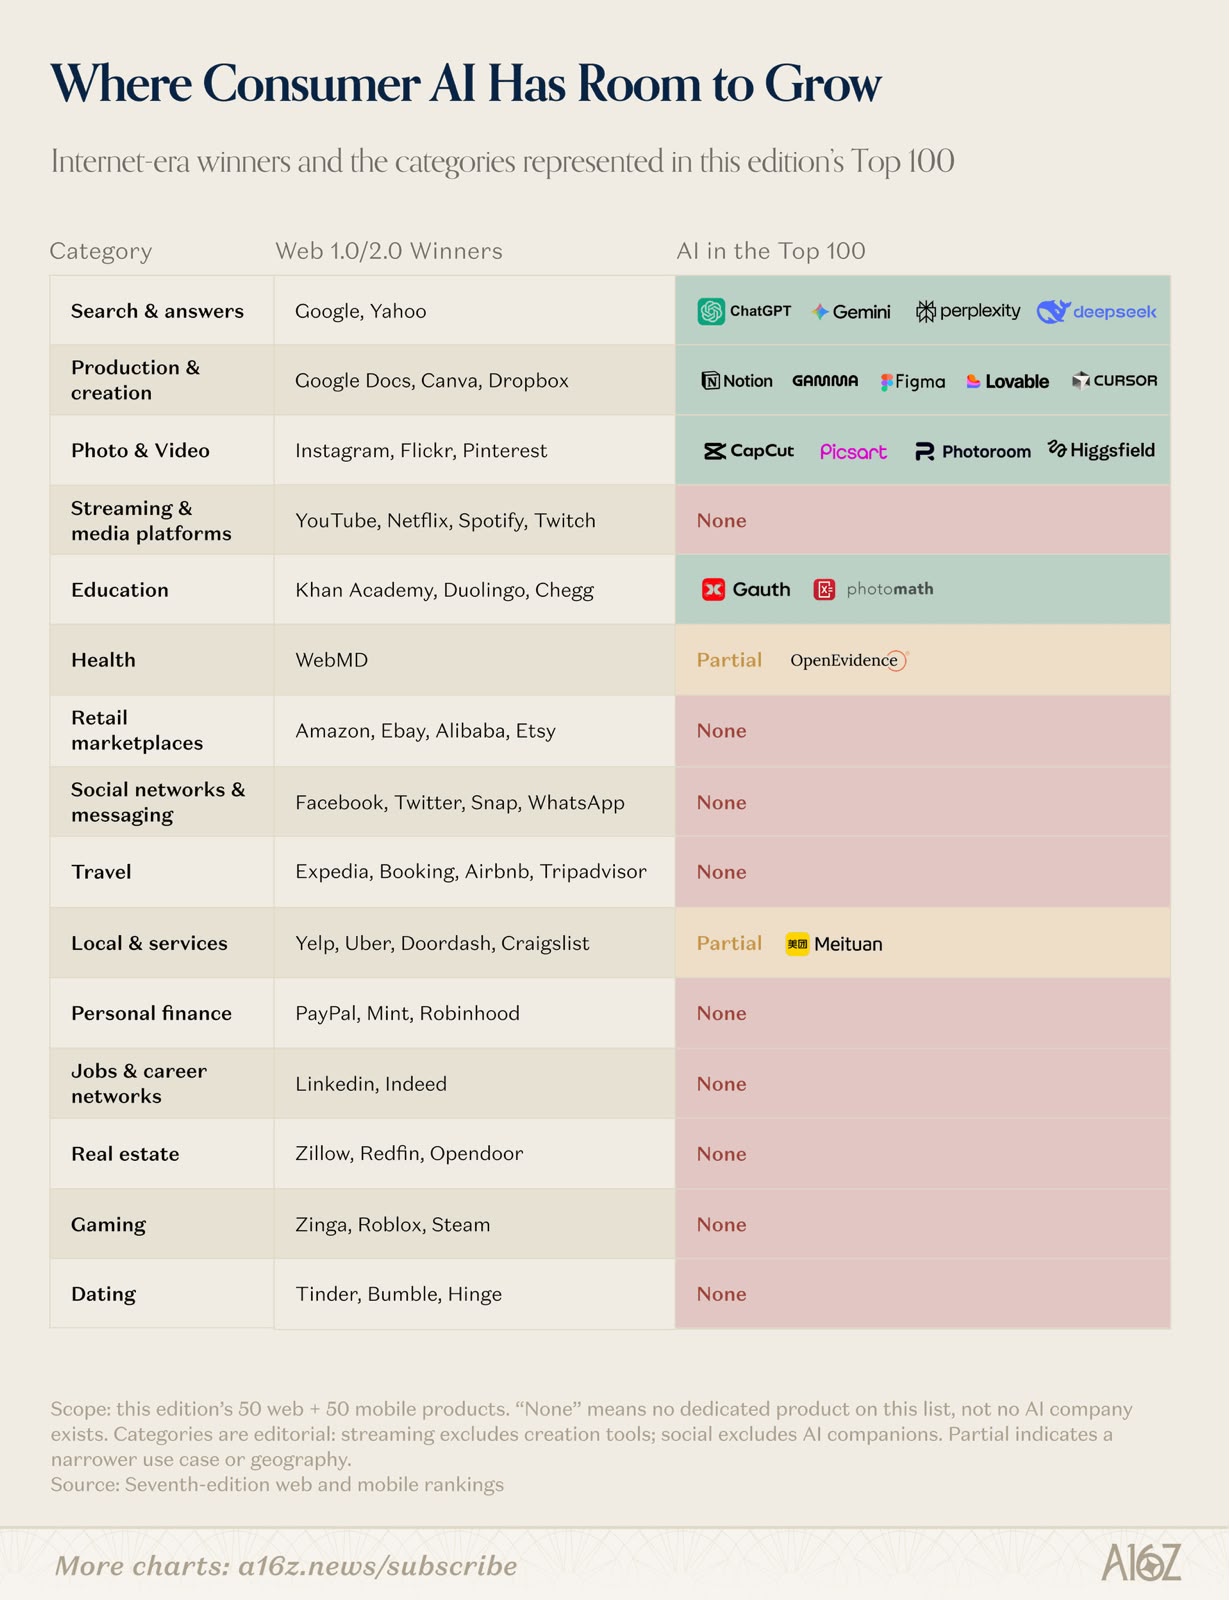
- Mercado. La séptima edición del Top 100 de aplicaciones de IA de consumo que publica la firma de inversión a16z sumó por primera vez una dimensión de gasto observado, con datos de panel de consumidores, junto a las visitas web y los usuarios móviles que ya medía. El hallazgo central contradice la sensación de ubicuidad: en agosto de 2026 solo el 4,5% de los consumidores estadounidenses tenía una suscripción paga activa a ChatGPT, Gemini o Claude.
→ https://a16z.com/100-gen-ai-apps-7/
- Costos. La consultora SemiAnalysis publicó el 5 de octubre una comparación del valor equivalente en API que entrega cada plan de suscripción: compró los planes, corrió tareas largas de programación hasta agotar los límites y valorizó el consumo a precio de lista de las respectivas API. En el tramo de US$200 mensuales, el plan Max 20x de Anthropic rinde unos US$11.726 de valor equivalente, contra US$2.084 del plan Pro de OpenAI. La misma proporción se repite en el tramo de US$20.
→ https://aiweekly.co/alerts/semianalysis-claude-200-plan-offers-5x-openais-api-value
- Seguridad. OpenAI publicó la arquitectura de su Defense Factory, una operación de seguridad que automatiza el ciclo completo de inventario, descubrimiento de vulnerabilidades, validación, asignación de responsables y despliegue de parches, apoyada en dos modelos especializados: Daybreak Blue para descubrir y analizar, Daybreak Red para triar y validar. En su propio despliegue reportan 0,81% de falsos positivos tras validación dinámica y 0,53% de reversiones en los parches aplicados.
→ https://openai.com/the-defense-factory/
- Cuota de uso. Los datos de septiembre de 2026 de StatCounter, que mide más de 3.000 millones de páginas vistas mensuales, dan a ChatGPT 80,48% del tráfico de asistentes conversacionales, Gemini 10,91%, Perplexity 5,85%, Copilot 1,79%, Claude 0,95% y DeepSeek 0,02%. Es tráfico web medido en navegador: no incluye uso por API, por interfaz de línea de comandos ni dentro de editores de código.
→ https://gs.statcounter.com/ai-chatbot-market-share
Qué considerar
Generar dejó de ser caro; comprobar no. El episodio de los 722 manuscritos es el caso extremo de un patrón que ya aparece en cualquier equipo que trabaja con asistentes: el volumen de material producido supera con holgura la capacidad de revisarlo, y el costo se traslada entero al revisor. La diferencia la hace el mecanismo de comprobación que viene incorporado. Donde existe —una demostración en Lean, una batería de pruebas que corre sola, un parche que se despliega y se revierte si falla— la producción se puede escalar sin que la revisión explote. Donde no existe, cada entregable adicional consume tiempo experto que no se repone. La pregunta útil para cualquier flujo asistido por IA no es cuánto produce, sino qué evidencia comprobable produce junto al resultado; si la respuesta es ninguna, el ahorro aparente se está pagando aguas abajo.
El precio de lista dejó de informar cuánto estás comprando. El ejercicio de SemiAnalysis muestra que dos planes del mismo precio pueden diferir cerca de cinco veces en consumo efectivo, y la contracara es que esos planes operan con márgenes profundamente negativos cuando el usuario los exprime: a utilización máxima, el tramo de US$200 de Anthropic arroja un margen bruto de −369%, y solo a una utilización del orden del 20% el margen se vuelve apenas positivo. Las suscripciones representan cerca del 10% de los ingresos de estas empresas pero consumen más del 40% de su cómputo de inferencia. Eso no es sostenible como está, y el ajuste llega siempre por el mismo lado: los límites se mueven. La objeción más extendida entre quienes dependen de estos planes —que los topes aparecen justo cuando el trabajo va en serio— describe bien el síntoma, pero la conclusión práctica es otra: ningún caso de negocio debería apoyarse en el nivel de límites vigente este mes.
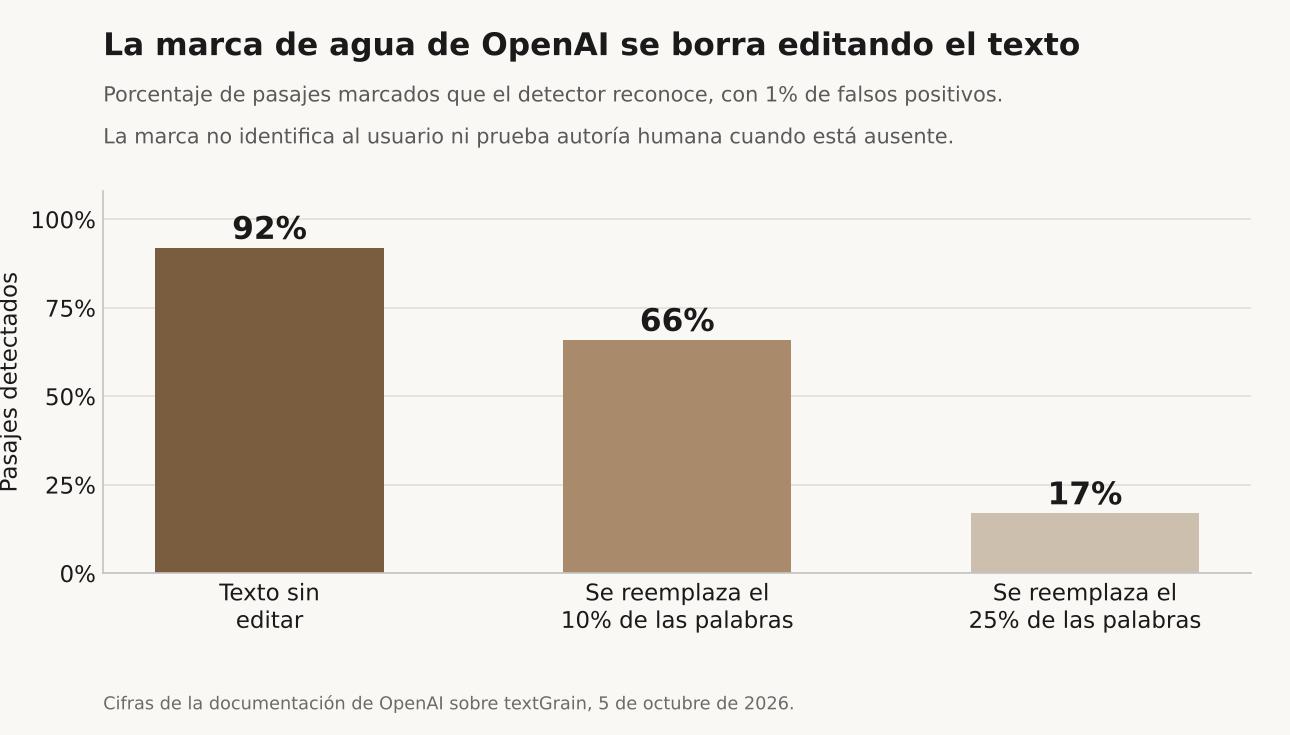
La marca de agua resuelve menos de lo que su nombre promete. Vale la pena leer con cuidado las cifras que la propia OpenAI publica. Con una tasa de falsos positivos del 1%, el detector reconoce alrededor del 80% de los pasajes de 200 tokens y cerca del 95% de los de 400; en textos matemáticos, donde la elección de palabras está mucho más restringida, el desempeño cae de forma sustancial. Y basta reemplazar una de cada diez palabras para que la detección baje de 92% a 66%, y una de cada cuatro para que caiga a 17%. OpenAI es explícita en lo que la herramienta no hace: no mide cuánto aportó una persona, no establece propiedad, no identifica al usuario y no prueba autoría humana cuando la marca está ausente. Sirve para detectar uso descuidado, no uso deliberadamente encubierto. Cualquier política institucional que se apoye en detectarla como prueba va a fallar en el caso que más importa.
Markdown se volvió la capa de interoperabilidad entre personas y agentes. Que Google habilite edición nativa de .md en Docs es, en sí mismo, una novedad menor de producto; lo relevante es el motivo que da en el anuncio, que es el mismo que explica por qué editores y gestores de notas lo están adoptando en paralelo: los modelos escriben y leen Markdown, y la cadena especificación-plan-documento-salida ya empieza y termina en ese formato. Para un equipo esto tiene una consecuencia concreta y barata: mantener la documentación interna —especificaciones, procedimientos, criterios de aceptación— en texto plano estructurado y versionado la vuelve legible y editable por los agentes sin trabajo de conversión. Lo contrario, documentación encerrada en formatos binarios propietarios, es hoy una barrera de adopción que no se ve en ningún tablero.
Lanzamientos y productos
- OpenAI liberó la arquitectura de su Defense Factory junto con una interfaz de línea de comandos de seguridad para Codex, y abrió por postulación el acceso a los modelos Daybreak para trabajo defensivo. Los indicadores de su propio despliegue —250 personas movilizadas, 54 problemas urgentes cerrados el primer día, 37% de hallazgos duplicados, 90,6% de aceptación del ruteo automático de responsables— son del fabricante, sin auditoría externa.
→ https://openai.com/the-defense-factory/
- La aplicación de ChatGPT para iOS incorporó el 2 de octubre widgets de pantalla de inicio que muestran tareas recientes y el consumo restante con su hora de reinicio. Es un cambio cosmético con un efecto real: vuelve visible un límite que antes solo se descubría al chocar con él.
→ https://learn.chatgpt.com/docs/changelog
Regulación y gobernanza
- La marca de agua de OpenAI no llega por demanda del mercado sino por el reglamento europeo de IA, que obliga a marcar el contenido generado sintéticamente. De ahí la asimetría del despliegue: obligatoria en la Unión Europea para los productos de consumo, opcional en la API para el resto del mundo. Es el patrón que ya se vio con la protección de datos: una norma regional fija el estándar técnico que termina implementándose globalmente, aunque se active por defecto en un solo mercado.
→ https://openai.com/index/eu-text-provenance/
- La publicación masiva de resultados matemáticos abrió un conflicto de normas, no de hechos. Las objeciones públicas de matemáticos académicos apuntan a tres cosas: que el volumen desborda cualquier capacidad de arbitraje, que difundir resultados por repositorio y redes sociales sustituye un proceso de revisión que existe por buenas razones, y que equipos humanos que trabajaban en los mismos problemas se encontraron con el terreno ocupado. Es la primera vez que una disciplina entera tiene que decidir qué hace con producción automatizada a una escala que no puede absorber.
→ https://finance.biggo.com/news/1d522643-5fd9-4ac5-ae86-e4a5b99edfe2
Para tu lista
- DeepSeek Harness (
dsh), marco de agentes de código abierto bajo licencia MIT, construido sobre una arquitectura donde todo componente —modelo, herramientas, habilidades, sesiones, entorno aislado, orquestación— es un plugin intercambiable. Está en vista previa para desarrolladores y sus autores anuncian cambios incompatibles, así que conviene fijar versión antes de apoyarse en él.
→ https://github.com/deepseek-ai/deepseek-harness
- rtk (Rust Token Killer), un proxy de línea de comandos que comprime la salida de los comandos antes de que llegue al modelo, con una reducción declarada de 60% a 90% del consumo de tokens en comandos habituales de desarrollo. Binario único sin dependencias, licencia Apache 2.0, con integración documentada para 17 herramientas de codificación asistida.
→ https://github.com/rtk-ai/rtk
- El repositorio
openai/math, si quieres mirar el material directamente: incluye un mapa de contenidos, los manuscritos en PDF y una biblioteca Lean con el catálogo de qué resultados tienen demostración formal y cuáles no. Esa distinción es lo primero que conviene revisar de cualquier resultado que te interese.
→ https://github.com/openai/math
- Muse, el agente personal de Meta que ejecuta tareas de forma autónoma —enviar correos, reservar viajes, completar formularios— y sigue operando con la aplicación cerrada. Se lanzó el 8 de septiembre y sigue disponible solo en Estados Unidos, sin fecha anunciada para América Latina.
→ https://about.fb.com/news/2026/09/introducing-muse-personal-ai-agent/