
Un atacante automatizado entró a un proveedor de identidad por su herramienta de ventas
Edición del 2 al 4 de noviembre · Panorama de IA para profesionales del sector
El caso de la semana
WorkOS, una empresa que vende infraestructura de autenticación empresarial —el componente que permite a una aplicación conectar el inicio de sesión corporativo de sus clientes—, informó el 2 de noviembre que sufrió un incidente de seguridad. Lo relevante no es el robo en sí, sino cómo ocurrió: la intrusión se atribuye a ARTEX, un marco de ataque que opera con agentes autónomos, y el punto de entrada no fue el producto sino una aplicación interna de ventas.
- Qué es ARTEX. Es un marco de pruebas de penetración autónomo: un agente planificador decide los siguientes pasos y otros agentes ejecutan herramientas de exploración de red y de autenticación, volcando los resultados en un grafo compartido de activos y hallazgos. Se publicó como código abierto en GitHub en julio de 2026 y su autor lo cerró el 8 de octubre, cuando ya acumulaba más de 12.000 copias derivadas. Microsoft vincula su uso a Storm-0940, un actor que describe como alineado con el Estado chino, y lo ha visto apuntar específicamente a proveedores de TI, de software y de identidad.
→ https://www.wiz.io/blog/artex-in-the-wild-storm-0940-expands-targeting-of-it-and-software-vendors
- Qué cambia respecto de un ataque manual. Las cifras de una campaña observada dan la medida: ráfagas de intentos de contraseña de veinte a sesenta minutos con una mediana de un segundo entre intentos, más de sesenta variantes de rutas de inicio de sesión federado probadas en dos minutos con un token de sesión sin firmar, más de quince identificadores de navegador distintos para evadir bloqueos y sesiones de ataque que se extendieron entre veinticuatro y treinta horas. La mayoría de los intentos falló. El atacante no se cansó.
→ https://www.wiz.io/blog/artex-in-the-wild-storm-0940-expands-targeting-of-it-and-software-vendors
- Qué se llevó y qué no. Según el boletín de la empresa, el acceso se limitó a una aplicación interna de ventas que contenía datos de contacto de clientes, historial de cuentas, resúmenes y extractos de llamadas comerciales, conversaciones de soporte y fragmentos de canales de Slack compartidos con clientes. La compañía sostiene que los sistemas de producción no fueron alcanzados y que no se accedió a datos de la plataforma. Un aviso enviado a clientes añade que el atacante llegó a una API interna y desde ahí a instancias de Salesforce y Snowflake; ese detalle no aparece en la comunicación pública y no está confirmado.
→ https://dev.to/gabrielanhaia/an-ai-attack-framework-got-into-workoss-sales-tool-it-held-customers-slack-excerpts-4m4c
También esta semana
- Costos. El costo de operar Grok Bot, el asistente de xAI integrado en X, era "insosteniblemente alto en relación con los ingresos", según dijo Elon Musk el 1 de noviembre, después de que suscriptores reclamaran que sus límites de uso se agotaban en días. Dos semanas antes había calificado el crecimiento del producto como el más rápido que había visto, y la presidenta de SpaceX había cifrado en 800.000 los usuarios de pago semanales a comienzos de octubre, más del doble que el mes anterior. Los planes cuestan 30, 100 y 200 dólares mensuales.
→ https://www.forbes.com/sites/siladityaray/2026/11/02/musk-says-grok-bots-costs-were-unsustainably-high-weeks-after-touting-rapid-growth/
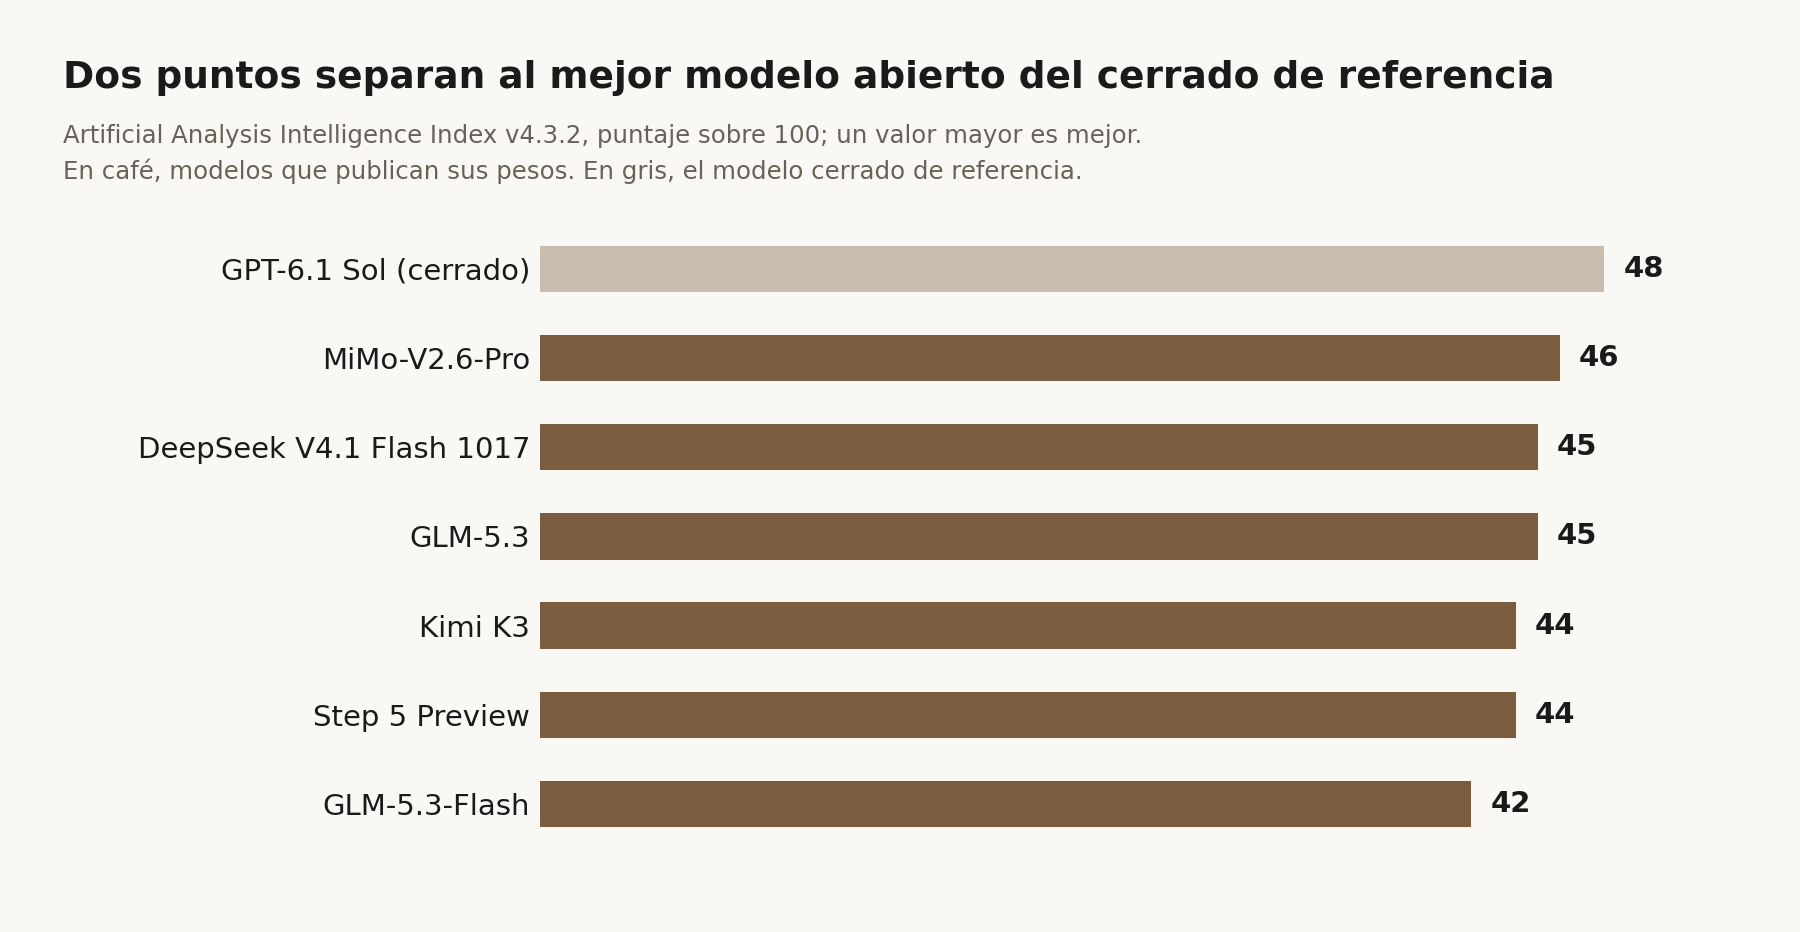
- Modelos abiertos. DeepSeek publicó una actualización de su modelo de pesos abiertos —aquellos cuyos parámetros se descargan y se ejecutan en infraestructura propia— llamada V4.1 Flash 1017, que obtuvo 45 puntos en el Artificial Analysis Intelligence Index, seis más que la versión anterior. Queda empatada en el segundo lugar entre los abiertos y a dos puntos del modelo cerrado de referencia en ese índice.
→ https://officechai.com/ai/deepseek-v4-1-flash-1017-places-ahead-of-glm-5-3-kimi-k3-on-artificial-analysis-intelligence-index/
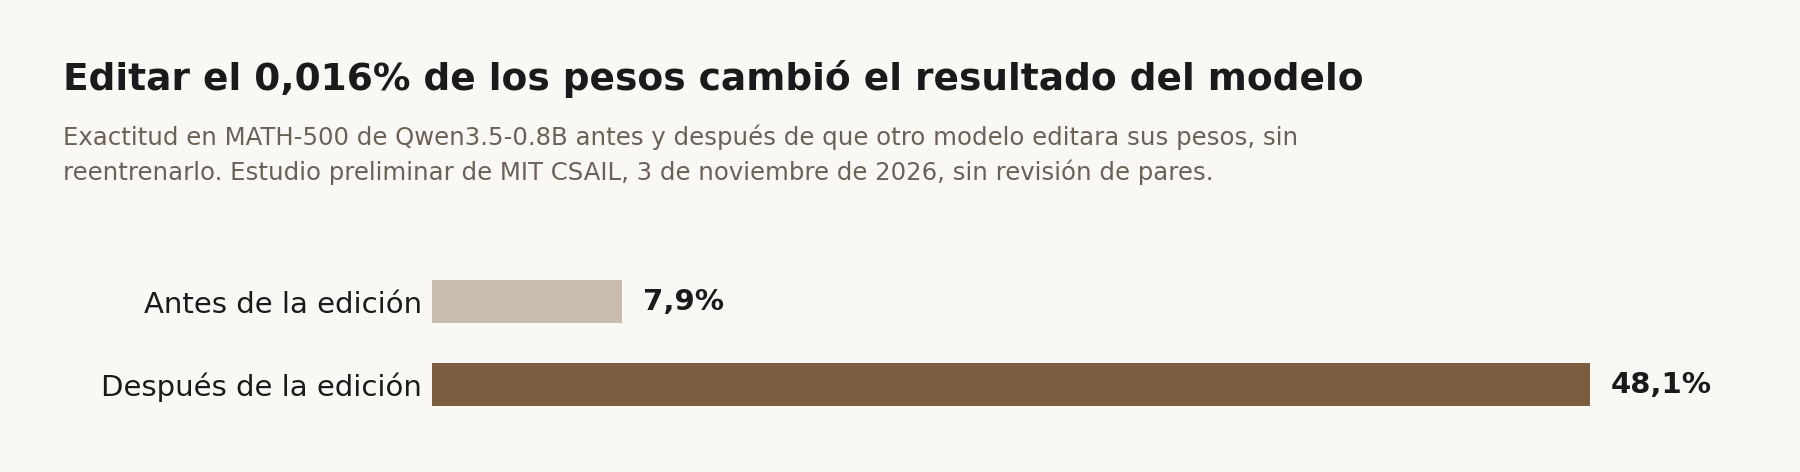
- Investigación. Un estudio preliminar de MIT CSAIL, publicado el 3 de noviembre, muestra que un modelo grande puede corregir a uno pequeño editando directamente sus parámetros numéricos, sin reentrenarlo. Al modificar el 0,016% de los pesos de un modelo de 800 millones de parámetros, su exactitud en una prueba estándar de matemáticas pasó de 7,9% a 48,1%. El trabajo no tiene revisión de pares y la técnica solo funcionó donde había un defecto que remover: en un modelo que no incurría en el mismo error, la mejora fue casi nula.
→ https://www.theregister.com/ai-and-ml/2026/11/03/forget-retraining-ai-can-now-tweak-another-ais-weights/5307105
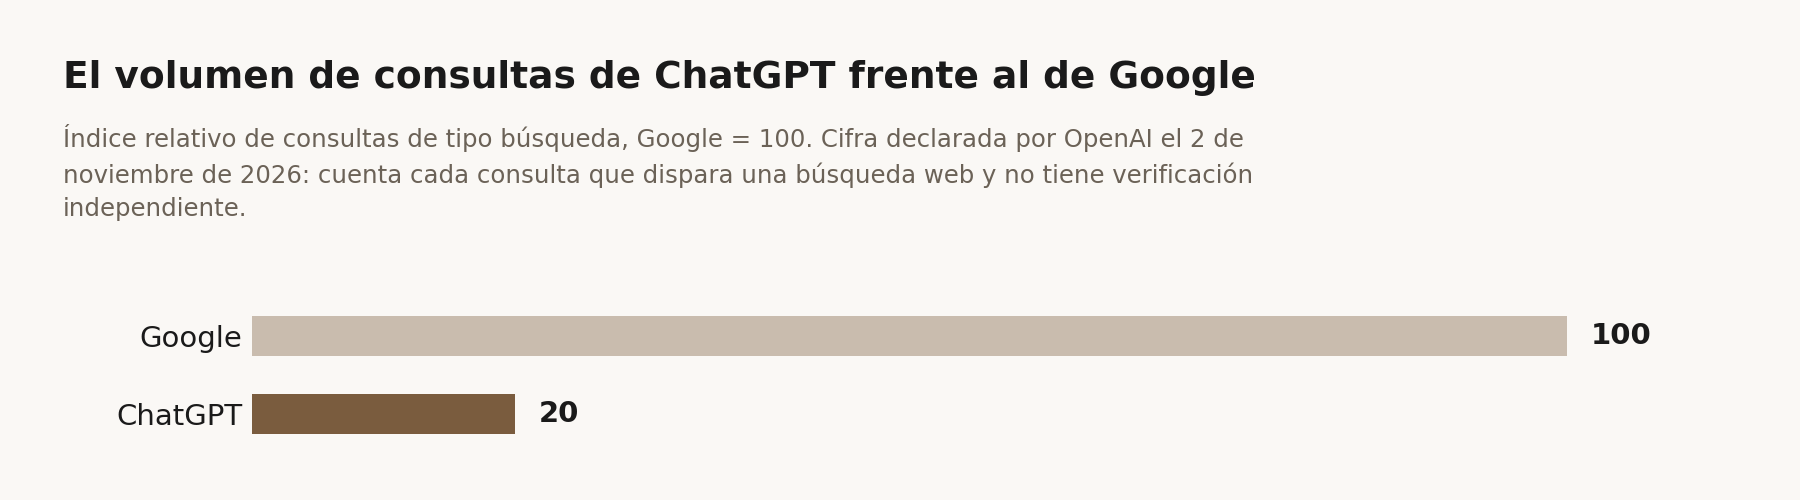
- Búsqueda. El volumen de consultas de tipo búsqueda de ChatGPT equivale aproximadamente a un quinto del de Google, según afirmó el responsable de producto de consumo de OpenAI en un encuentro con prensa el 2 de noviembre. La cifra merece cautela: la empresa cuenta cada consulta que dispara una búsqueda web, no publicó la fuente del dato de Google y nadie la verificó de forma independiente.
→ https://9to5google.com/2026/11/03/chatgpt-has-hit-roughly-20-of-google-search-volume-openai-says/
- Agentes. Nous Research abrió el 30 de octubre la beta móvil de Hermes Agent, su marco de agentes de licencia abierta. El diseño es inusual: el agente, el modelo y los datos corren en una máquina del propio usuario —un servidor virtual o un computador— y el teléfono funciona solo como cliente para aprobar las llamadas a herramientas que el agente solicita. No hay una factura de modelo adicional por usar la aplicación.
→ https://aicoder.com/news/news-20261031-nous-hermes-agent-mobile-beta-ios-testflight-android-firebase-own-gateway
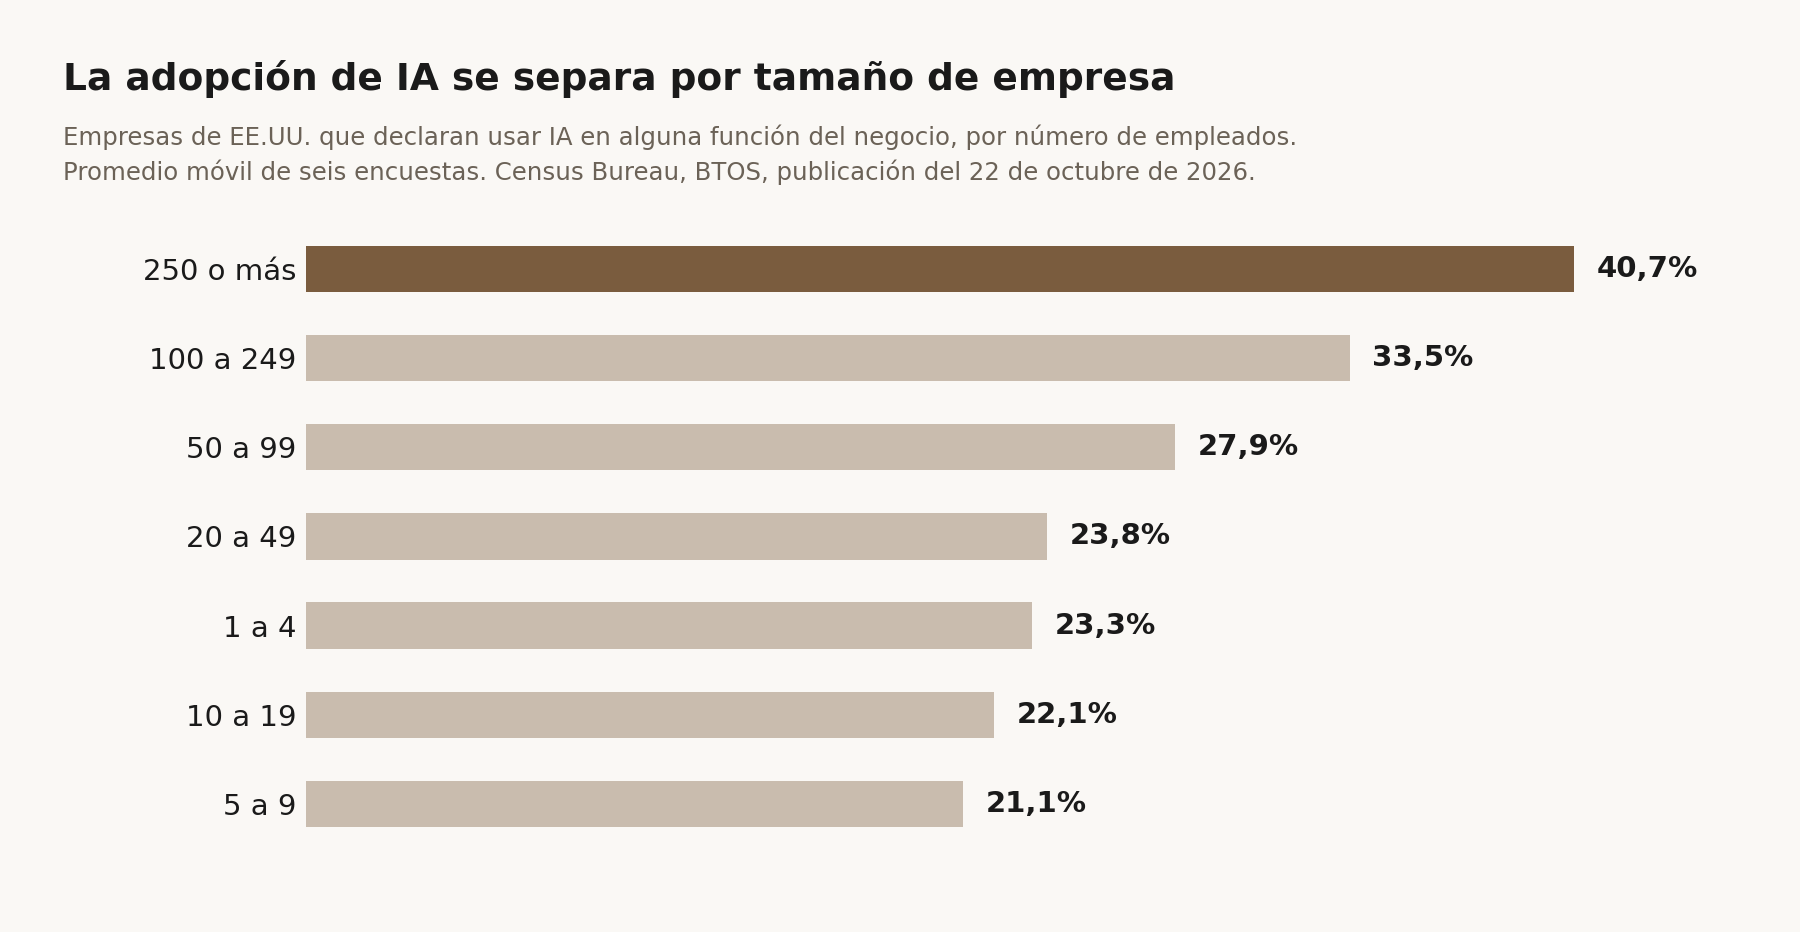
- Medición. La Oficina del Censo de Estados Unidos reemplazó en su encuesta empresarial BTOS el término "Inteligencia Artificial" por "Súper Inteligencia", en cumplimiento de la Orden Ejecutiva 14434, a partir de la recolección del 19 de octubre. Es el segundo cambio de redacción en un año en la serie más citada sobre adopción de IA en empresas: en noviembre de 2025 la pregunta había pasado de "producir bienes o servicios" a "cualquier función del negocio", lo que ya hizo incomparables los tramos anterior y posterior.
→ https://simonwillison.net/2026/Nov/2/census-bureau-super-intelligence/
Qué considerar
El perímetro que se defiende y el que se ataca dejaron de coincidir. El incidente de esta semana no se produjo en el producto de una empresa de seguridad, sino en la herramienta donde su equipo comercial guardaba contactos, historiales de cuenta y extractos de conversaciones con clientes. Ese tipo de sistema casi nunca entra en el alcance de una prueba de penetración ni en el inventario de activos críticos, porque no procesa transacciones ni almacena datos regulados. Pero contiene exactamente lo que vuelve creíble un fraude posterior: quién es la contraparte, de qué se habló, qué estaba pendiente. La implicancia práctica es de inventario, no de tecnología. Conviene listar qué aplicaciones internas —comerciales, de soporte, de marketing— tienen acceso a datos de clientes a través de integraciones, quién las administra y qué pasaría si su contenido quedara en manos de un tercero. Y conviene asumir, en los próximos meses, que cualquier solicitud inesperada que llegue citando una conversación real puede no venir de quien dice venir.
Un atacante que no se cansa cambia la aritmética de la autenticación. Las defensas contra intentos de contraseña masivos se diseñaron contra un adversario con costo marginal: alguien que prueba, falla y pasa al siguiente objetivo. Un agente que itera durante treinta horas, rota identificadores cuando lo bloquean y prueba sesenta variantes de una ruta de inicio de sesión en dos minutos no responde a esa economía. Lo que mantiene su efectividad no es un producto nuevo, son tres decisiones aburridas: eliminar los factores de autenticación que se pueden interceptar o reenviar, acortar el tiempo entre la detección y la revocación de una sesión sospechosa, y tratar cualquier cambio en la configuración de inicio de sesión federado —un certificado nuevo, una solicitud de "reconectar el directorio"— como una operación que solo se ejecuta desde el panel propio y nunca a pedido de un correo.
Un agente que pide "abrirle el escritorio" para pasar un segundo factor convierte su control de acceso en un trámite. La objeción más extendida entre quienes ya operan agentes con credenciales no es que fallen, es que funcionan: cuando un agente necesita entrar a un sistema y encuentra un passkey o un código de un solo uso, la solución práctica que todos descubren es que la persona lo apruebe en el momento. Hecho una vez es razonable; hecho veinte veces al día, el segundo factor dejó de ser un control y pasó a ser una molestia que se despacha sin leer. La corrección no es prohibir los agentes. Es darle a cada agente su propia identidad, con credenciales propias y permisos acotados a lo que necesita, en vez de prestarle la del operador; definir por escrito a qué sistemas un agente nunca se autentica en nombre de una persona —banca, firma electrónica, administración de identidades, nómina—; y registrar cada aprobación, de modo que exista un rastro de qué autorizó quién. Si hoy nadie en la organización puede responder qué sistemas tocó un agente la semana pasada, ese es el trabajo pendiente.
Las cuotas promocionales no son una base de costos. El episodio de Grok Bot es útil porque pone fecha a algo que se venía anunciando solo: un proveedor que presentó su crecimiento como un récord y, dos semanas después, declaró que servir el producto costaba más de lo que ingresaba. Lo mismo ocurre, sin el ruido, en los precios de interfaz de programación: el modelo de frontera de Google mantiene tarifa introductoria hasta el 30 de noviembre y la duplica el 1 de diciembre. Quien dimensionó un caso de negocio con los precios o los límites de hoy debería rehacer el cálculo con dos escenarios adicionales: el precio al doble y el límite a la mitad. Si el caso no sobrevive a ninguno de los dos, el problema no es el proveedor, es que el caso dependía de un subsidio temporal.
Modelos y plataformas
- Precio y puntaje de los modelos abiertos. La actualización de DeepSeek se ofrece a 0,30 dólares por millón de tokens de entrada y 1,20 por millón de salida en horas de mayor demanda, y a la mitad fuera de ellas. Tiene 552.000 millones de parámetros totales con 16.000 millones activos por consulta, ventana de contexto de un millón de tokens y licencia MIT. Su costo por tarea del índice es de 0,26 dólares; el modelo abierto que lidera el ranking resuelve la misma tarea por 0,13.
→ https://artificialanalysis.ai/models/deepseek-v4-1-flash-1017
- Dos tarifas con fecha de vencimiento. El modelo de frontera de Google cuesta hoy 2 dólares por millón de tokens de entrada y 10 por millón de salida, precio que rige hasta el 30 de noviembre y pasa a 4 y 20 el 1 de diciembre. En la aplicación de consumo los límites no se publican como número de consultas sino como consumo de cómputo, que se reinicia cada cinco horas hasta alcanzar un tope semanal, lo que explica que un mismo prompt consuma una fracción muy distinta de la cuota según el modo en que se ejecute.
→ https://ai.google.dev/gemini-api/docs/models/gemini-4-argon
Investigación
- Editar pesos en vez de reentrenar. El trabajo de MIT CSAIL describe un procedimiento al que llama programación en el espacio de pesos: un modelo capaz lee los parámetros de otro, identifica el patrón responsable de un comportamiento indeseado —en el caso estudiado, quedarse en bucle al razonar— y lo modifica directamente. El cambio afectó a una fracción minúscula de los parámetros y el salto de desempeño fue de más de cuarenta puntos porcentuales. La advertencia del propio estudio importa tanto como el resultado: la técnica mejora lo que está roto y no hace nada donde no hay nada que reparar.
→ https://www.xataka.com/robotica-e-ia/ia-ha-hecho-mejor-a-otra-ia-metodo-inesperado-recortarle-que-le-estorbaba
Regulación y litigios
- Chile: el proyecto de ley de IA avanzó en el Senado. La Comisión de Desafíos del Futuro aprobó en general el texto por 4 votos a 0 y lo despachó a la sala para su segundo trámite constitucional. El proyecto clasifica los usos en cuatro niveles de riesgo, prohíbe la inferencia de emociones en colegios y lugares de trabajo, la identificación biométrica remota en tiempo real en espacios públicos, la recolección masiva e indiscriminada de imágenes faciales y los sistemas de puntuación social con efectos discriminatorios, y contempla multas de hasta 20.000 UTM. La comisión propuso el 4 de diciembre como plazo de indicaciones. El Ejecutivo prepara una propuesta sustitutiva de enfoque más flexible, con certificación voluntaria y sin sanciones específicas para IA, que no se había presentado al momento de la votación. Hasta que el proyecto sea ley, ninguna de estas obligaciones rige.
→ https://www.malaespinacheck.cl/pais/2026/10/27/ley-de-ia-avanza-en-el-senado-que-usos-prohibiria-y-como-afectaria-a-colegios-empresas-y-al-estado/
En la región
- Microsoft aporta cómputo a Latam GPT. CENIA, el centro nacional de inteligencia artificial de Chile, y Microsoft firmaron a fines de octubre un memorando de cooperación a dos años para el desarrollo de Latam GPT, el modelo de lenguaje abierto construido con datos latinoamericanos que se presentó en febrero de este año. El aporte de la primera fase son 250.000 dólares en créditos de nube, vigentes hasta febrero de 2027, más asesoría técnica y estudios conjuntos en educación, servicios públicos y salud. El modelo se entrenó con más de 300.000 millones de tokens en español y portugués, con la contribución de cerca de 60 instituciones de 15 países. El argumento de fondo sigue siendo el mismo: el español representa alrededor del 4% y el portugués cerca del 2% de los datos con que se entrenan los grandes modelos.
→ https://cenia.cl/2026/10/29/microsoft-y-cenia-le-dan-motor-a-latam-gpt-el-primer-gran-modelo-de-lenguaje-abierto-de-america-latina/
- La adopción regional, medida. El informe de difusión de IA de Microsoft correspondiente al segundo trimestre sitúa el uso global en 18,8% de la población en edad de trabajar, con 28,8% en el norte global y 16,2% en el sur. En América Latina encabezan Costa Rica (29,7%), Colombia (25,9%), República Dominicana (25,8%) y Uruguay (25,7%); Chile aparece con 24,0%, por encima de Argentina (23,4%), México (21,4%), Brasil (20,2%) y Perú (17,3%).
Para tu lista
- Hermes Agent, marco de agentes de licencia MIT con gateway propio: útil para quien necesita que el modelo y los datos no salgan de infraestructura controlada. https://hermes-agent.nousresearch.com/mobile
- Artificial Analysis, para contrastar puntaje, precio por tarea y velocidad de salida antes de elegir modelo. https://artificialanalysis.ai/
- El análisis de Wiz sobre ARTEX, con el patrón de ataque paso a paso y reglas de detección concretas para equipos que operan Okta o Entra. https://www.wiz.io/blog/artex-in-the-wild-storm-0940-expands-targeting-of-it-and-software-vendors
- ISO/IEC 42001, la norma certificable de sistemas de gestión de inteligencia artificial: es la referencia que están pidiendo las áreas de compras cuando preguntan por gobernanza de IA, y la vía más corta para quien ya tiene ISO 27001 andando. https://www.iso.org/standard/42001