
Dos laboratorios dicen que su IA derribó un supuesto de 27 años, y nada se volvió más rápido
Edición del 30 de octubre al 2 de noviembre · Panorama de IA para profesionales del sector
El caso de la semana
La hipótesis del tiempo exponencial (ETH, por su sigla en inglés) es un supuesto que la informática teórica dio por bueno desde 1999: que el problema 3-SAT —decidir si una fórmula lógica con tres condiciones por cláusula puede satisfacerse— exige un tiempo de cómputo que crece exponencialmente con el número de variables. Sobre ese supuesto descansan buena parte de las demostraciones de que ciertos algoritmos de optimización, ruteo y asignación ya son lo mejor posible. Dos laboratorios afirman ahora, con días de diferencia, que sus modelos lo refutaron.
- Qué se afirmó. El 26 de octubre OpenAI publicó un preprint, producido por un modelo interno, que sostiene un algoritmo para 3-SAT con tiempo subexponencial en el peor caso. Ese mismo día Anthropic anunció que un modelo propio había llegado de forma independiente al mismo resultado y publicó los detalles en GitHub. Ninguno de los dos trabajos ha pasado por revisión de pares.
→ https://en.wikipedia.org/wiki/Exponential_time_hypothesis
- Qué tan firme está. La formalización en Lean —el asistente de demostraciones que permite que una máquina verifique cada paso de un argumento matemático— que acompaña al trabajo de OpenAI cubre una cota más débil que la afirmación del paper. Es decir: lo que está verificado por máquina es menos de lo que se anunció. Russell Impagliazzo y Ramamohan Paturi, los dos autores que formularon la hipótesis en 1999, junto con Ryan Williams, aceptaron revisar el material.
→ https://www.rdworldonline.com/openai-ai-refuted-exponential-time-hypothesis-math-physics-proofs/
- Qué no cambió. No existe hoy ningún solucionador más rápido como consecuencia de esto. Un algoritmo subexponencial en el peor caso teórico puede seguir siendo impracticable en cualquier instancia real, y las heurísticas que la industria usa hoy para programar turnos, armar rutas o asignar recursos no se vuelven ni mejores ni obsoletas por el anuncio.
→ https://es.wired.com/articulos/openai-y-anthropic-derriban-una-hipotesis-de-27-anos-y-sacuden-la-informatica-teorica
También esta semana
- Herramientas. Cursor, el editor de código con IA que SpaceX adquirió en agosto, perderá el acceso directo a los modelos de OpenAI el 12 de noviembre. Quien tenga flujos de trabajo apoyados en GPT dentro de ese editor necesita un plan de migración con fecha, no una revisión genérica de proveedores.
→ https://www.infoworld.com/article/4216503/cursor-customers-will-lose-access-to-openai-coding-models-in-november.html
- Costos. OpenAI unificará en diciembre la cuota de uso de ChatGPT y la de Codex, su agente de programación, en una sola bolsa compartida para los planes Plus, Pro y Business. Las conversaciones en el modo Instant no descontarán de esa bolsa, y quien la agote podrá esperar el reinicio o comprar créditos adicionales.
→ https://www.unite.ai/openai-sets-shared-chatgpt-and-codex-usage-allowance-for-december/
- Planes. Anthropic renombró sus dos planes de suscripción alta: el de 100 dólares pasa a llamarse Max y el de 200, Ultra, sin cambio de precio. Ultra elimina la ventana móvil de cinco horas —el tope que hasta ahora cortaba el uso intensivo y obligaba a esperar ese lapso para reanudarlo— en cuentas verificadas, aunque mantiene un límite semanal.
→ https://www.notebookcheck.net/Claude-Ultra-drops-the-five-hour-limit-for-verified-accounts.1438692.0.html
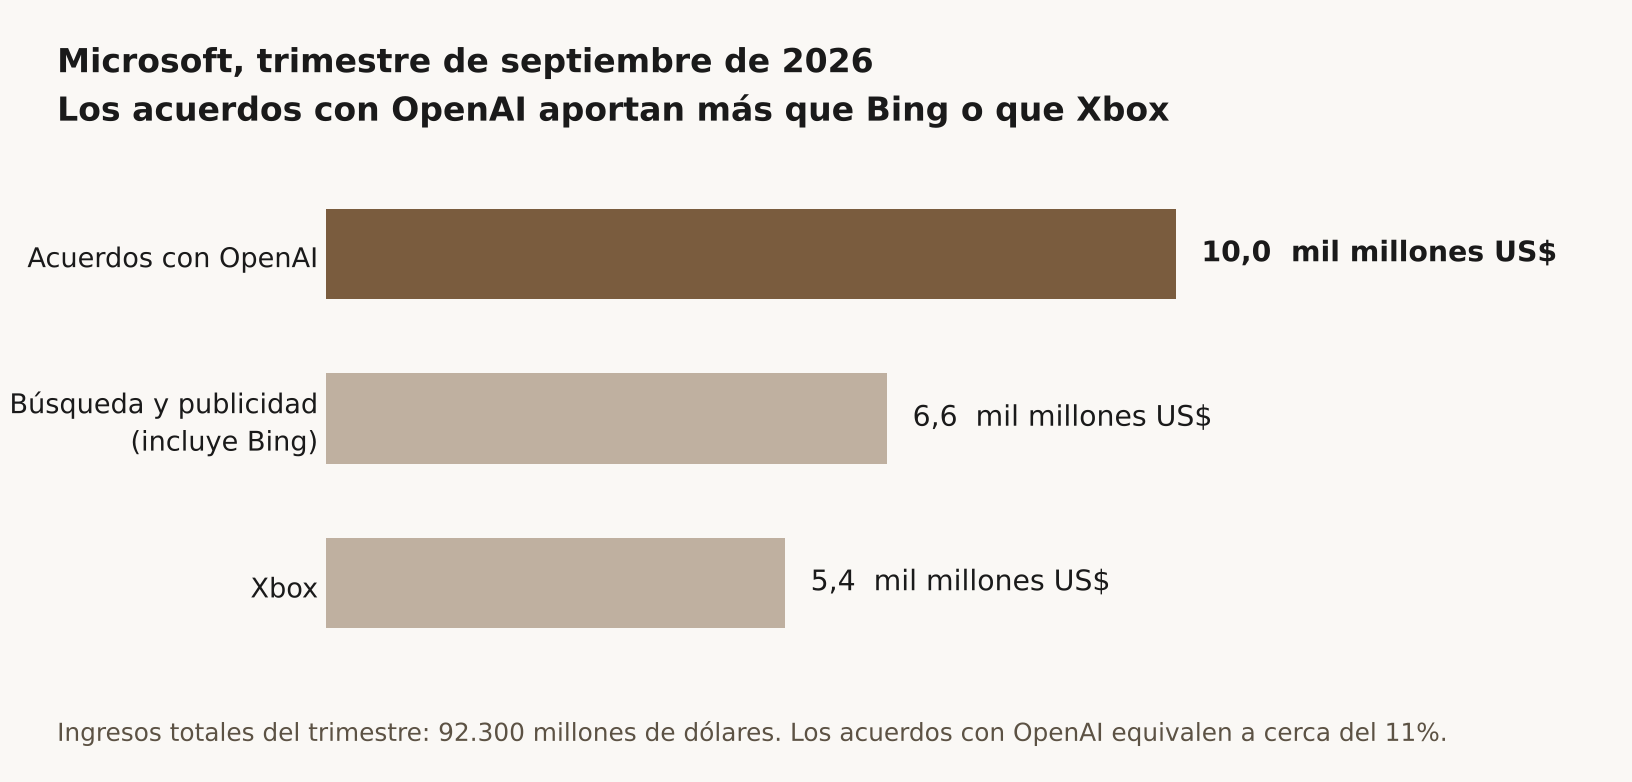
- Concentración. Microsoft reveló que sus acuerdos con OpenAI —reparto de ingresos más el consumo de Azure que hace esa empresa— le aportaron 10.000 millones de dólares en el trimestre de septiembre, cerca del 11% de sus ingresos totales. Es más que toda su división de búsqueda y publicidad, Bing incluido (6.600 millones), y más que Xbox (5.400 millones).
→ https://www.geekwire.com/2026/bigger-than-bing-or-xbox-microsofts-openai-haul-reaches-10b-in-quarterly-revenue/
- Financiamiento. OpenAI redujo la meta de su ronda de capital en curso de 30.000 a 20.000 millones de dólares y bajó la valoración esperada a 1,25 billones, según reportes que la empresa no ha confirmado. Lleva cerca de 11.000 millones comprometidos.
→ https://www.cnbc.com/2026/10/31/openai-fundraising-20-billion-valuation.html
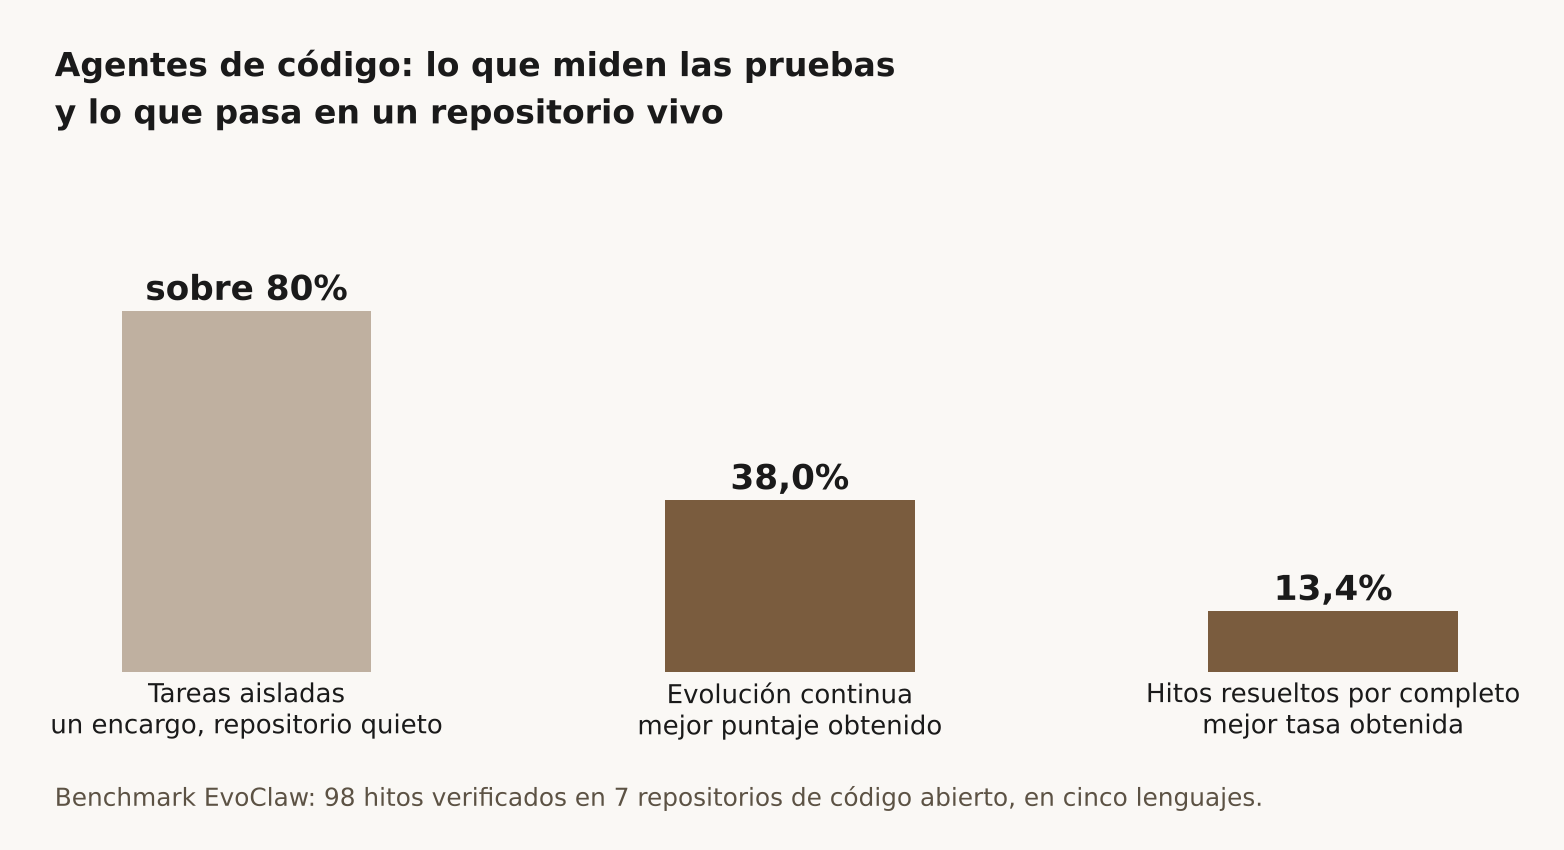
- Agentes. EvoClaw, un benchmark presentado este año en ICML, mide algo que las pruebas habituales no miden: si un agente mantiene un repositorio funcionando a lo largo de una secuencia de hitos que dependen unos de otros. El mejor puntaje obtenido en ese escenario es 38,03%, contra más de 80% que los mismos agentes logran en tareas aisladas.
→ https://arxiv.org/html/2603.13428v1
- Investigación. Un trabajo de Randall Balestriero y Yann LeCun sobre arquitecturas JEPA —modelos que aprenden prediciendo representaciones abstractas en lugar de la siguiente palabra— reporta que su método necesitó 42 veces menos muestras que la predicción de siguiente token para alcanzar una alineación comparable entre texto e imagen, y que un modelo de texto de 109 millones de parámetros superó en esas pruebas a modelos de hasta 72.000 millones.
→ https://huggingface.co/papers/2610.39302
Qué considerar
El cuello de botella se movió de producir resultados a verificarlos. El episodio de la hipótesis del tiempo exponencial es instructivo justamente por su desenlace incómodo: hay dos afirmaciones fuertes, publicadas, con material disponible, y la demostración verificada por máquina cubre menos que lo anunciado. Quienes pueden revisarlo con autoridad son un puñado de especialistas en el mundo, y van a tardar. El patrón se repite en escala mucho menor dentro de cualquier organización que ya usa estas herramientas: el costo de generar un análisis, un informe o un parche de código cayó a casi cero, y el costo de comprobar que está bien no cayó nada. La consecuencia práctica no es desconfiar de la herramienta, es presupuestar la verificación. Para cualquier resultado producido con IA sobre el que se vaya a actuar, conviene definir antes —no después— quién lo revisa, con qué método y en cuánto tiempo; si no hay respuesta para esas tres cosas, el resultado todavía no está listo para usarse.
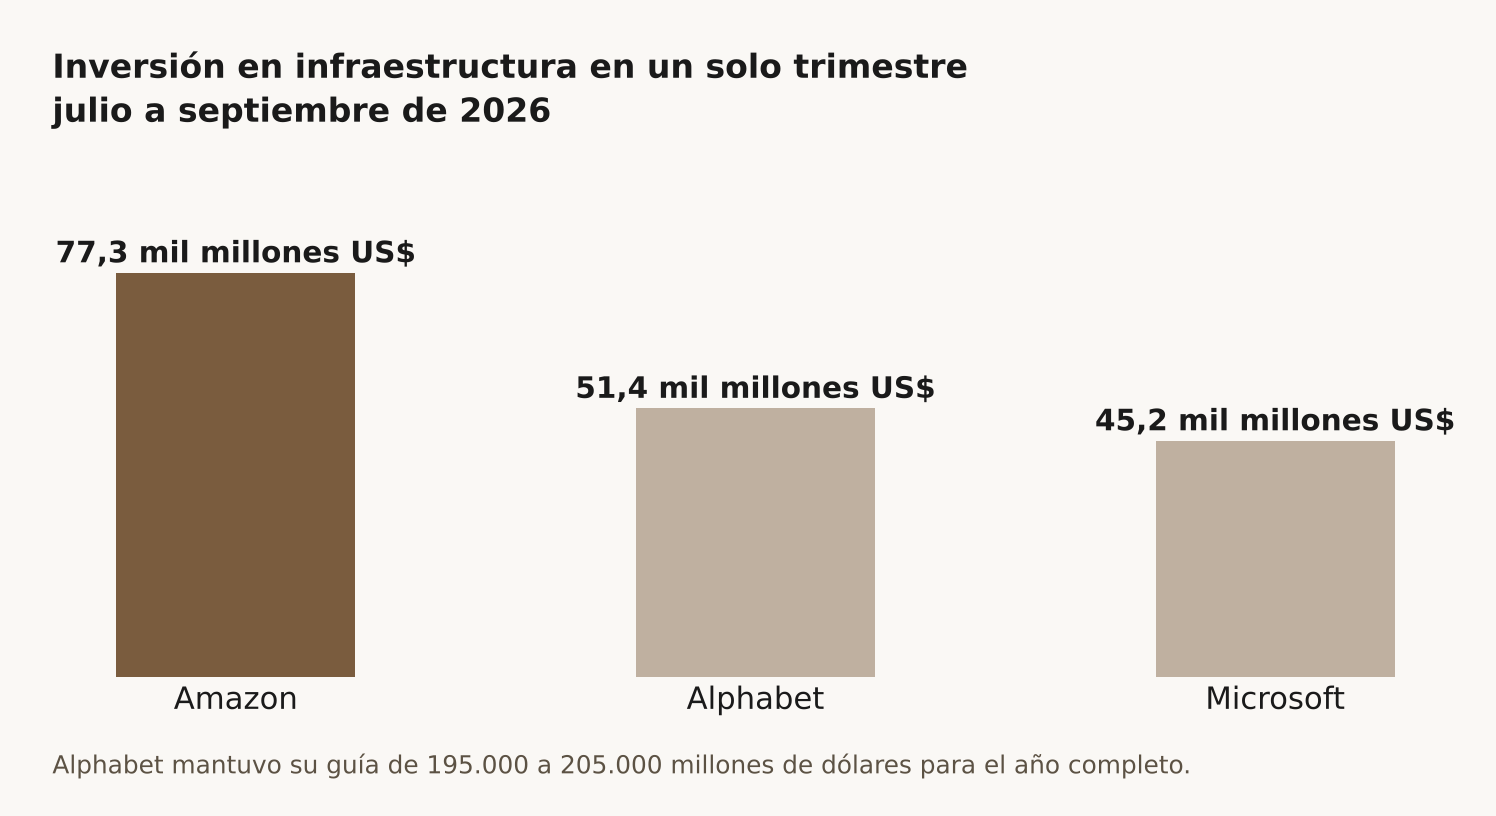
"El precio refleja expectativas futuras" y "hay una burbuja" no son la misma afirmación. La objeción más extendida a la tesis de la burbuja es correcta y poco informativa: el precio de cualquier acción siempre refleja flujos futuros esperados, de modo que constatarlo no distingue a este sector de ningún otro. La pregunta que sí se puede responder con datos es otra: cuánta de la inversión en cómputo está siendo financiada por contrapartes que son a la vez clientes, proveedores e inversionistas entre sí. Ahí hay cifras concretas. La inversión en infraestructura de un solo trimestre de las tres mayores plataformas de nube suma más de 170.000 millones de dólares, y una parte creciente de los ingresos que la justifican proviene de un número muy pequeño de contrapartes. Para quien contrata servicios sobre esta infraestructura, la implicancia es de continuidad operacional, no de bolsa: conviene saber de qué proveedor depende cada carga de trabajo crítica y tener probada —no solo escrita— la ruta de salida hacia un segundo proveedor.
Los agentes se evalúan en tareas aisladas y se usan en evolución continua. El dato de EvoClaw merece atención porque explica una frustración muy común: el piloto funcionó y la puesta en producción decepcionó. La razón no es que el equipo lo haya hecho mal. Las pruebas estándar presentan un encargo acotado sobre un repositorio que no se mueve; el trabajo real es una cadena de cambios donde cada uno hereda los errores y la deuda del anterior. Medido así, el mejor resultado disponible hoy cae a 38% de puntaje, y si se exige que todas las pruebas de un hito pasen, a poco más de 13%. La implicancia es sobre cómo se mide, no sobre si conviene usar agentes: la tasa de éxito que importa es la que se obtiene sobre un repositorio que sigue cambiando durante varias semanas, y esa cifra hay que medirla en casa, porque ningún benchmark público la va a entregar para su código.
La garantía de cifrado no es uniforme dentro de un mismo proveedor, y una política que dice "usar mensajería cifrada" no es un control. Conviene tenerlo presente al definir por dónde pueden circular los datos de la organización: dentro de una misma familia de productos conviven canales con cifrado de extremo a extremo y canales sin él —Meta retiró el cifrado de extremo a extremo de los mensajes directos de Instagram en mayo de este año—, y en los canales cifrados la garantía protege el tránsito, no impide que el contenido quede a la vista cuando uno de los interlocutores lo reporta o lo reenvía. Una política utilizable no menciona el cifrado: nombra los canales aprobados para cada tipo de dato y los prohibidos, y se revisa cada vez que un proveedor cambia las condiciones de uno de ellos. → https://www.bitdefender.com/es-es/blog/hotforsecurity/meta-elimina-cifrado-extremo-a-extremo-instagram
Modelos y plataformas
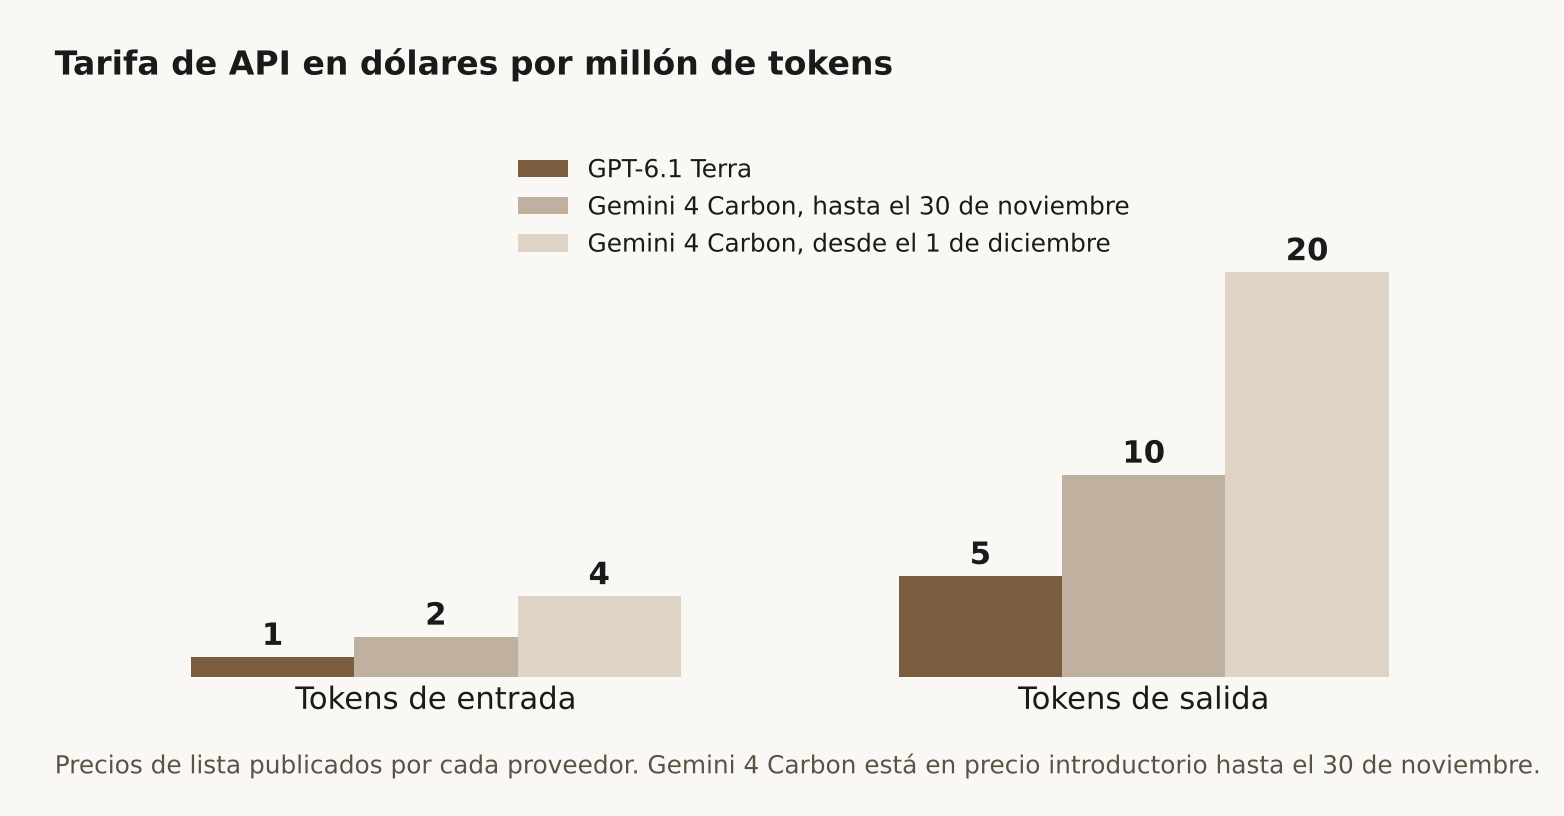
- Precios de frontera. El modelo más reciente de OpenAI, GPT-6.1 Terra, se lanzó el 26 de octubre a 1 dólar por millón de tokens de entrada y 5 por millón de salida, la mitad de lo que costaba su antecesor. Gemini 4 Carbon, de Google, mantiene precio introductorio de 2 y 10 dólares hasta el 30 de noviembre y pasa a 4 y 20 el 1 de diciembre.
→ https://www.bleepingcomputer.com/news/artificial-intelligence/openai-launches-gpt-61-terra-with-3x-faster-ai-agents-50-percent-lower-pricing/
- Apple en China. Apple confirmó sus primeras funciones de Apple Intelligence para China: las pruebas con desarrolladores empiezan el 4 de noviembre y el despliegue llega en diciembre junto con iOS 27.3. Qwen, de Alibaba, impulsa funciones seleccionadas, y el nuevo Siri no entra en esta fase.
→ https://theneuron.ai/digest/everything-that-happened-in-ai-today-monday-november-2-2026
- Cómputo en órbita. Google hizo correr su modelo Gemma 4 sobre una TPU de clase centro de datos a bordo de un satélite prototipo. La propia responsable de energía de la compañía estimó que, en las condiciones actuales, un centro de datos orbital podría costar hasta cien veces más que uno terrestre.
→ https://theneuron.ai/digest/everything-that-happened-in-ai-today-monday-november-2-2026
Movimientos de industria
- La dependencia cruzada quedó cuantificada. Los 10.000 millones que OpenAI le aportó a Microsoft en un trimestre son la cifra más clara publicada hasta ahora de hasta qué punto los resultados de una gran plataforma dependen de un solo cliente del sector. Crece incluso mientras ambas empresas aflojan sus vínculos: OpenAI ya usa otros proveedores de nube y Microsoft construye modelos propios y trabaja con Anthropic.
→ https://www.geekwire.com/2026/bigger-than-bing-or-xbox-microsofts-openai-haul-reaches-10b-in-quarterly-revenue/
- La salida a bolsa de Anthropic apunta a mediados de noviembre. La compañía presentó su formulario S-1 el 26 de octubre para listarse en el Nasdaq bajo el símbolo ANT, con 16.300 millones de dólares de ingresos en el primer semestre y una pérdida neta de 80.700 millones, de la cual 72.400 millones corresponden a un cargo contable por el mayor valor de sus notas convertibles. El documento consigna que sus cinco mayores clientes representaron cerca del 25% de los ingresos.
→ https://fortune.com/2026/10/26/anthropics-s-1/
- Adquisición. Salesforce acordó comprar Rune Technologies, que desarrolla software de planificación logística militar. La prensa sitúa la operación cerca de los 375 millones de dólares; Salesforce no informó el precio.
→ https://theneuron.ai/digest/everything-that-happened-in-ai-today-monday-november-2-2026
Regulación y gobernanza
- Garantías contractuales en educación. Desde el 1 de noviembre, los distritos escolares de Estados Unidos pueden exigir en sus contratos con Microsoft el estándar de privacidad y seguridad de IA que la empresa acordó con el sindicato de profesores en septiembre: limita el uso de datos de estudiantes y docentes para entrenamiento y publicidad, y obliga a supervisión humana en decisiones de consecuencia. Es el ejemplo más concreto disponible de cláusulas de IA exigibles, y sirve de plantilla fuera del sector educativo.
→ https://www.forbes.com/sites/danfitzpatrick/2026/09/09/microsoft-offers-schools-enforceable-ai-guardrails/
- Infraestructura y litigios. Un juez federal permitió avanzar una demanda de la NAACP por turbinas a gas presuntamente instaladas sin permiso en la planta Colossus de xAI. El fallo es procesal y no establece responsabilidad, pero confirma que el permiso ambiental de la infraestructura de cómputo ya es una vía de litigio con efectos sobre plazos de obra.
→ https://theneuron.ai/digest/everything-that-happened-in-ai-today-monday-november-2-2026
- Chile. La postergación de la Ley 21.719 de protección de datos personales todavía no es ley. El Senado la aprobó en primer trámite —33 votos a favor y 6 en contra— y pasó a la Cámara de Diputadas y Diputados; mientras no se publique, la fecha vigente sigue siendo el 1 de diciembre de 2026, no el 15 de octubre de 2027 que propone el proyecto.
→ https://ciberlatam.com/noticias/chile-posterga-ley-datos-personales
Para tu lista
- Portal, de Spotify. El equipo de ingeniería de Spotify liberó la configuración interna con la que redujo cerca de 90% el consumo de tokens de su agente de programación. El mecanismo es acotar qué contexto entra en cada llamada en lugar de arrastrar el repositorio completo, y es replicable sin usar su complemento.
→ https://engineering.atspotify.com/2026/9/portal-by-spotify-cut-my-claude-code-token-usage-by-90/
- global-law. Un repositorio que organiza la legislación de múltiples jurisdicciones como un solo historial de git, con los commits ordenados por fecha de entrada en vigencia, lo que permite consultar el texto vigente a una fecha dada y ver qué cambió entre dos. Incluye un servidor MCP de solo lectura que funciona local y sin llamadas de red. La cobertura es muy despareja: algunos países tienen el cuerpo legal completo y Estados Unidos, solo nueve títulos del código federal.
→ https://github.com/lexifina/global-law
- EvoClaw. El paper del benchmark de evolución continua, útil sobre todo por su metodología: cómo convertir historiales de git ruidosos en secuencias de hitos verificables con pruebas. Sirve de guía para armar una evaluación equivalente sobre un repositorio propio.
→ https://icml.cc/virtual/2026/poster/65024
- Lectura. Un paper de posición que sostiene que los agentes constituyen un cambio de paradigma en la entrega de software y no una mejora incremental. Vale la pena leerlo con el mismo criterio con que se lee cualquier tesis fuerte: sus definiciones y su revisión de benchmarks son aprovechables, y sus conclusiones sobre ingeniería autónoma son proyecciones del autor, no resultados medidos.
→ https://arxiv.org/html/2606.05608v1