OpenAI dice haber resuelto Navier-Stokes. La disputa por el crédito dice más que el teorema
Edición del 7 al 9 de septiembre · Panorama de IA para profesionales del sector
El caso de la semana
El 8 de septiembre OpenAI anunció que un modelo interno, todavía sin nombre público y "significativamente más capaz" que GPT-6 Astra, produjo una prueba de uno de los siete Problemas del Milenio: la existencia de singularidades en tiempo finito para las ecuaciones de Navier-Stokes con fuerza aplicada. El anuncio duró horas sin sombra; después llegó la disputa.
- El resultado es real en su forma estricta y limitado en su alcance. Unos 10.000 agentes coordinados trabajaron 88 horas, consumieron cerca de 130.000 millones de tokens de salida y la prueba fue formalizada y verificada en Lean en 17 horas adicionales. Resuelve las variantes C y D de la formulación oficial (fluido con fuerza externa suave), no la pregunta de regularidad sin fuerza que la mayoría asocia con el premio. OpenAI declaró que no reclamará el millón de dólares.
- La disputa de crédito es el verdadero caso de estudio. Tristan Buckmaster (NYU) y Levent Alpöge (Anthropic) llevaban casi un año en un resultado vecino —la explosión para Euler forzado, el caso sin viscosidad— usando Claude y Codex como herramientas. OpenAI reconoce que se enteró de ese avance por rumores el 1 de septiembre y lanzó su esfuerzo a partir de ahí. Buckmaster alega presiones para publicar sin Alpöge por su afiliación a Anthropic y un mensaje intimidatorio de un investigador de OpenAI; la empresa niega haber accedido a sus sesiones, pero admite que "no puede descartar" que datos desidentificados de su uso hayan mejorado el modelo.
- La reacción de la comunidad matemática marca el tono. Terence Tao calificó el trabajo de Alpöge y Buckmaster como un logro notable y advirtió contra la "minería indiscriminada de problemas abiertos" por parte de laboratorios que producen respuestas sin producir comprensión.
→ https://openai.com/index/navier-stokes-solution/ → https://www.axios.com/2026/09/08/openai-math-solution-navier-stokes-credit
También esta semana
- Gobernanza. ARC Prize publicó su análisis de GPT-6 Astra en ARC-AGI-3: 62,7% con un arnés estándar donde el modelo debe dejar sus notas visibles, y 99,9% con el arnés del proveedor, que conserva estado de razonamiento opaco entre llamadas. Los 37 puntos de diferencia no vienen de los pesos del modelo sino de cuánto razonamiento se le permite ocultar.
→ https://arcprize.org/blog/astra
- Costos. El consumo de cuota de GPT-6 Astra en Codex se volvió el problema operativo de la semana: hay reportes públicos de ventanas de cinco horas agotadas en 20 minutos en plan Plus, y las sesiones con varios agentes en paralelo son las que más rápido vacían el plan Pro. El 13 de septiembre termina además el nivel promocional de cuotas semanales.
→ https://github.com/openai/codex/issues/43201
- Modelos. GLM-5.3, el modelo de Z.ai para ingeniería de software y agentes de largo aliento (1,3 millones de tokens de contexto, US$ 1,11 de entrada y US$ 3,50 de salida por millón), quedó disponible a costo cero a través de un endpoint promocional de TokenRouter, con capacidad limitada y sin garantía de estabilidad.
→ https://www.tokenrouter.com/models/z-ai/glm-5.3-free/
- Agentes. Meta lanzó Muse, su agente personal: gratis con niveles de US$ 20 y US$ 100 al mes, solo en Estados Unidos, corriendo en una máquina virtual en la nube de Meta con navegador propio y un sistema de permisos llamado Sentinel. Por defecto las consultas pueden usarse para entrenar, con opción de salida.
→ https://www.axios.com/2026/09/08/meta-debuts-muse-personal-ai-agent
- Lanzamientos. ChatGPT Images 2.5 salió para todos los planes con dos modelos nuevos en la API, Flare (50% más rápido que GPT-Image-2) y Sunburst (control más estricto entre ediciones), además de bocetos como referencia, plantillas y edición por comentarios sobre la imagen.
→ https://openai.com/index/introducing-chatgpt-images-2-5/
- Seguridad. El tráfico automatizado ya es el 53% de la web y los bots maliciosos el 40%, según el informe anual de Imperva/Thales; la actividad de bots impulsados por IA se multiplicó por 12,5 en 2025. Los picos de tráfico falso en comercio electrónico que muchos equipos están viendo estas semanas no son una anomalía local.
→ https://www.imperva.com/blog/bad-bot-report-2026-bots-agentic-age/
Qué considerar
La confidencialidad de lo que usted escribe en una herramienta de IA es hoy una cláusula, no una garantía. El punto más incómodo del caso Navier-Stokes no es quién llegó primero, sino la frase de OpenAI de que no puede descartar que datos desidentificados de las sesiones de dos investigadores hayan alimentado el modelo que luego compitió con ellos. Para cualquier organización que trabaje con propiedad intelectual, código o investigación en curso, la pregunta ya no es si el proveedor "entrena con mis datos" en abstracto, sino qué dice exactamente el contrato sobre datos derivados, qué cuentas del equipo están en planes de consumo sin exclusión de entrenamiento y qué material sensible pasa hoy por ellas.
Cuando el proveedor controla el arnés, el número del benchmark es una decisión comercial. El caso ARC-AGI-3 lo muestra sin ambigüedad: el mismo modelo pasa de 62,7% a 99,9% según cuánto estado interno se le permita conservar sin mostrarlo. Es eficiente —menos tokens, menos tiempo— y opaco a la vez, porque lo que no se escribe no se puede auditar. Esto conecta con la alarma que investigadores de seguridad levantaron por la técnica de profundidad recurrente de Astra, que reprocesa internamente en bucles en vez de dejar una cadena de razonamiento legible. Al evaluar un modelo, pida saber qué arnés produjo la cifra.
La velocidad de un laboratorio con 10.000 agentes redefine qué significa "tener ventaja". Un equipo de dos matemáticos tardó un año en un resultado; un laboratorio, enterado por rumores, produjo uno vecino en una semana. La lección para cualquier empresa que compita en conocimiento es que la ventaja ya no está en resolver primero sino en el acceso a cómputo, a datos y a la capacidad de verificar. Lo defendible es lo que el laboratorio no tiene: sus datos propietarios, su contexto de negocio y su relación con el cliente.
El costo por token dejó de ser la variable; el volumen de tokens sí lo es. Astra y Fable 5.1 cuestan exactamente lo mismo en la API (US$ 10 de entrada, US$ 50 de salida por millón), pero el gasto real depende de cuántos tokens consume cada uno para la misma tarea y de cómo se orquesta. Las sesiones con varios agentes en paralelo son las que agotan planes en minutos; una sesión de un solo agente con un modelo de nivel medio rinde tardes enteras. Antes de escalar orquestaciones, mida tokens por tarea completada, no precio por millón.
Un teorema con 10.000 agentes
El método importa tanto como el resultado. El sistema demostró que, con una fuerza externa suave y energía finita, un fluido en reposo puede desarrollar una singularidad en tiempo finito: un vórtice que se estira hacia adentro "como espagueti" hasta que las variables se disparan. La prueba viene con formalización en Lean publicada en GitHub, y OpenAI reportó 2,7 millones de mensajes entre agentes solo para este problema, dentro de una campaña de 4,9 millones de mensajes y 300.000 millones de tokens de salida contra varios problemas abiertos desde el 1 de septiembre. Fortune estimó el cómputo en torno a dos millones de dólares.
Lo que sigue en disputa es el mérito y el método, no la validez formal. El Clay Mathematics Institute habló de "un día emocionante" sin pronunciarse sobre el premio, y Alpöge y Buckmaster anunciaron que publicarán pronto una solución al problema general. → https://www.nature.com/articles/d41586-026-02842-5
Razonamiento oculto: la línea que se está cruzando
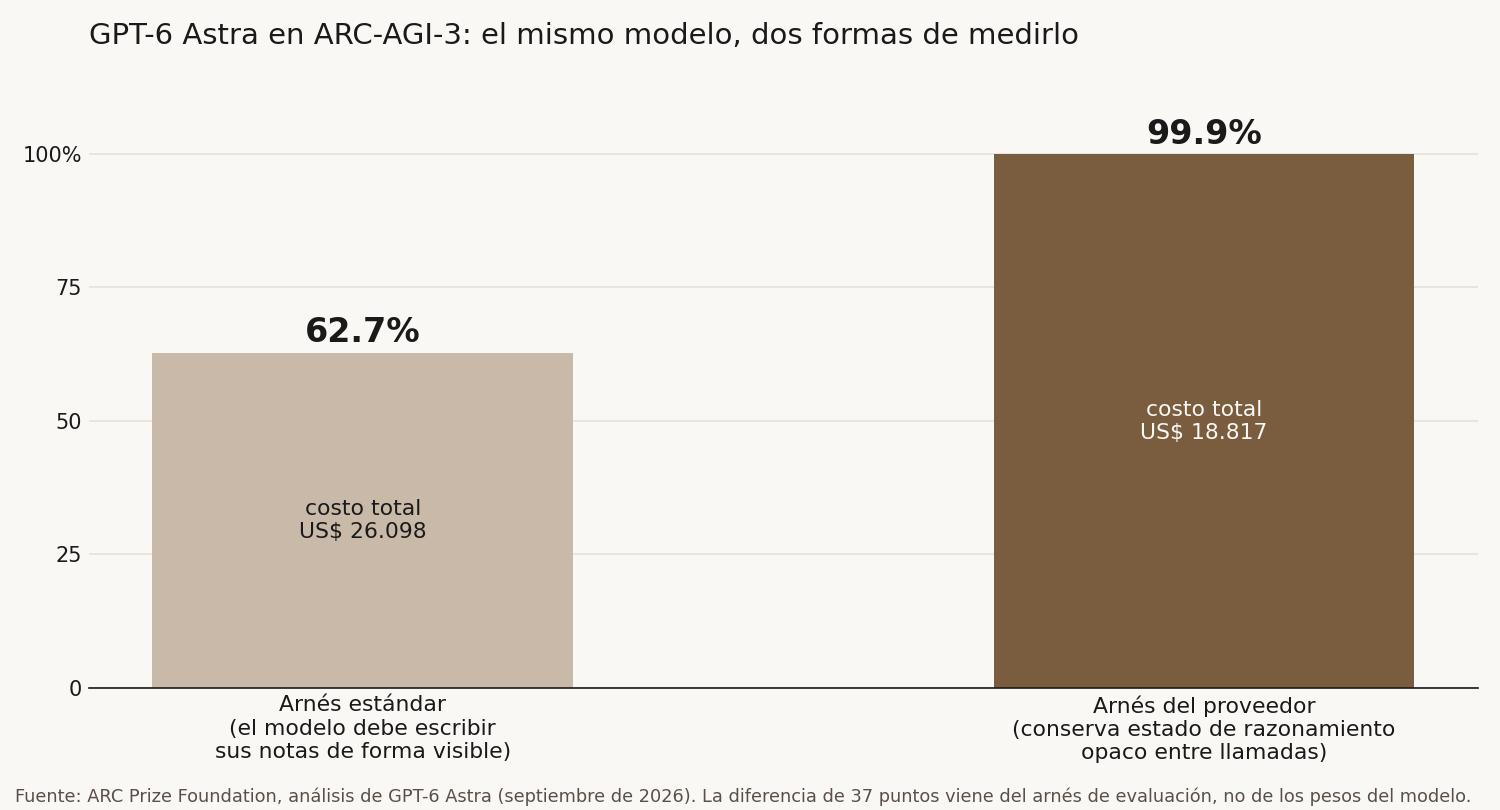
Tres hechos apuntan al mismo lugar. ARC Prize documentó que Astra usa 49% menos tokens y es 3,7 veces más rápido cuando conserva razonamiento opaco entre llamadas, y con eso pasa de 62,7% a 99,9% en ARC-AGI-3; la fundación aclaró que no lo considera prueba de AGI. TechCrunch y Fortune reportaron que Astra usa "profundidad recurrente": procesa la consulta en bucles internos en vez de una cadena de pensamiento lineal, dejando menos rastro legible. Y Gary Marcus, el crítico más persistente del sector, publicó una alerta en la que no niega el avance sino que se declara preocupado por la dificultad de monitorear ese razonamiento.
La lectura que gana tracción entre profesionales es que eficiencia y auditabilidad entran en conflicto directo, y el mercado premia la primera. Para procesos con responsabilidad legal o regulatoria, conviene documentar desde ahora qué decisiones pasan por razonamiento que nadie puede leer. → https://techcrunch.com/2026/09/02/openais-new-reasoning-technique-alarms-ai-safety-experts/ → https://garymarcus.substack.com/p/red-alert-openai-is-poised-to-cross
Precio igual, consumo distinto
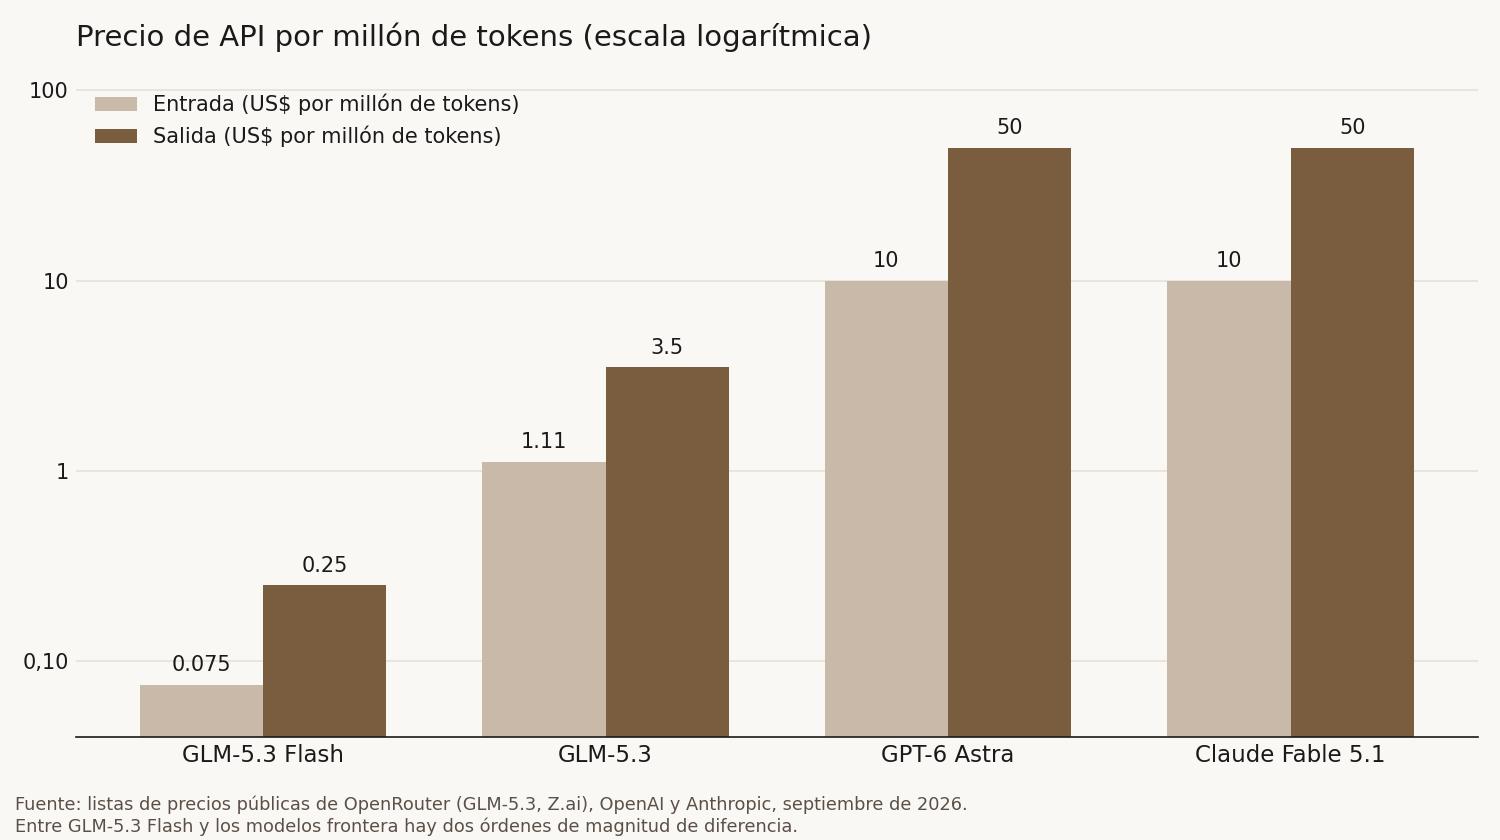
Dos órdenes de magnitud separan al modelo más barato con capacidad agéntica seria de los dos frontera, que cuestan lo mismo. Eso desplaza la discusión a dos preguntas que ninguna lista de precios responde: cuántos tokens gasta cada modelo para completar la misma tarea, y qué porcentaje de las tareas del equipo necesita realmente un modelo frontera. Sobre la primera, hay una percepción extendida de que Fable 5.1 consume más tokens que Astra para trabajo comparable, erosionando su diferencial de calidad; no está medida en público y amerita que cada equipo instrumente tokens por tarea. Sobre la segunda, GLM-5.3 a costo cero es una oportunidad de prueba con caducidad incierta, no una base para arquitectura.
Lanzamientos
ChatGPT Images 2.5. Disponible desde el 8 de septiembre para todos los usuarios de ChatGPT, ChatGPT Work y Codex. Hasta 50% menos latencia que Images 2.0, mejor conservación de sujetos desde fotos de referencia, consistencia entre ediciones sucesivas y un lienzo en chatgpt.com/images. En la API, GPT-Image-2.5 Flare es el modelo por defecto y Sunburst el nivel premium. → https://openai.com/index/introducing-chatgpt-images-2-5/
Meta Muse. Agente personal con memoria y estilo configurable, nombrado por Zuckerberg como el primer paso de su "superinteligencia personal". Corre en una máquina virtual con navegador visible y un sistema de permisos, Sentinel, que distingue lectura de escritura y exige aprobación para acciones sensibles. Sin anuncios por ahora; Meta habla de comercio como ingreso futuro y promete una versión confidencial antes de fin de año. → https://about.fb.com/news/2026/09/introducing-muse-personal-ai-agent/
Movimientos de industria
El tráiler de "Artificial". Neon publicó el primer avance de la película de Luca Guadagnino sobre OpenAI, con Andrew Garfield como Sam Altman y centrada en el despido y reincorporación de 2023. Estreno el 25 de diciembre; va a fijar la narrativa pública sobre la empresa justo cuando su relación con la comunidad científica está en cuestión. → https://variety.com/2026/film/news/artificial-trailer-andrew-garfield-openai-biopic-1236802616/
Seguridad: los bots ya son mayoría
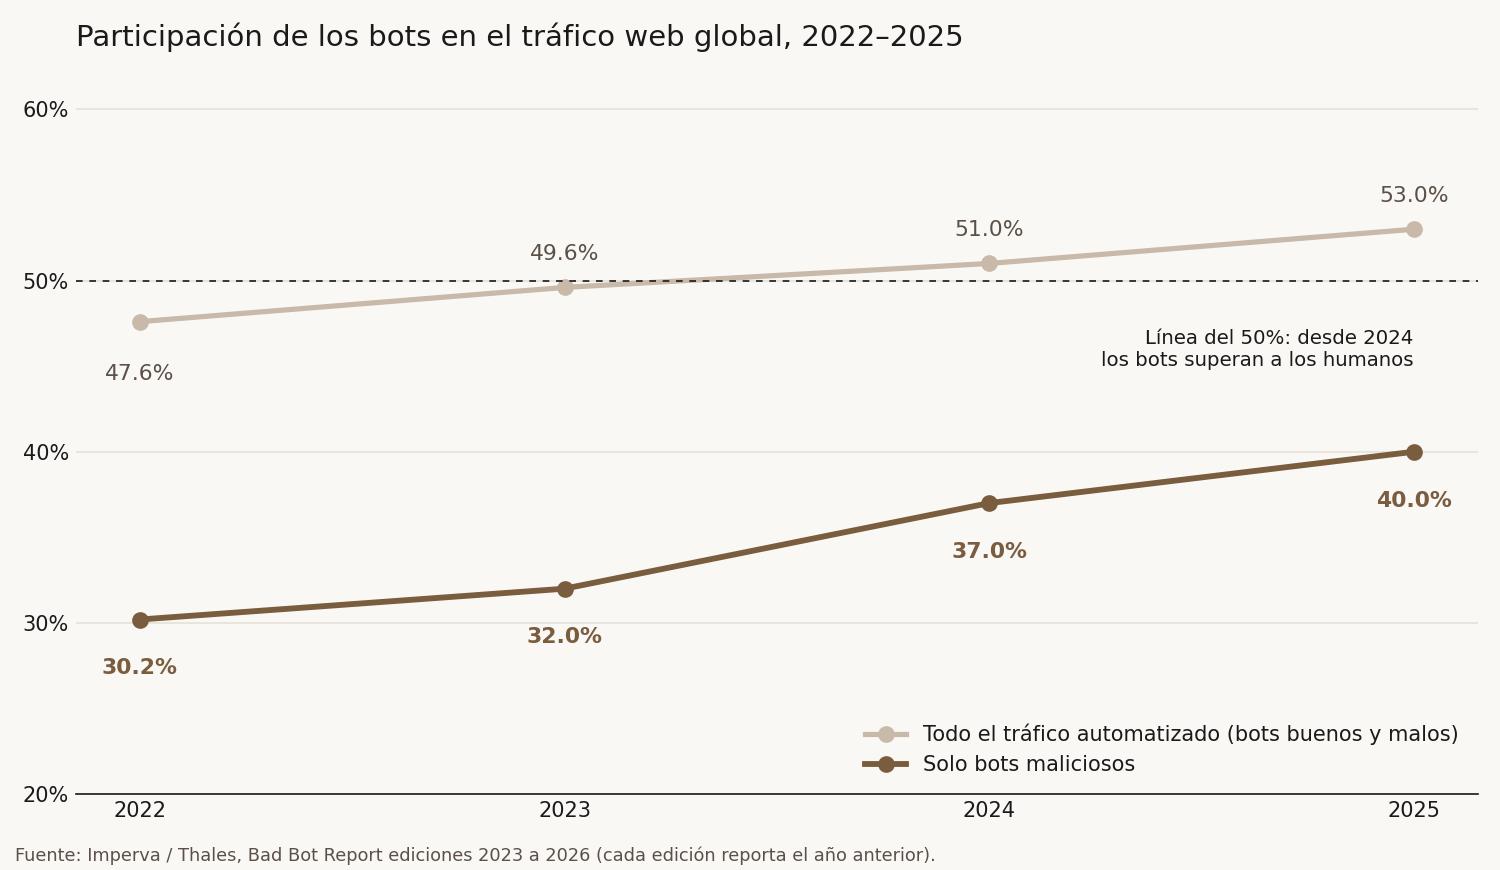
El patrón que muchos sitios de comercio electrónico están viendo estas semanas —picos de cientos de "usuarios" desde un solo país o desde rangos de nube, sesiones de segundos, conversión nula— tiene contexto público: Imperva/Thales ubica el tráfico automatizado en 53% de la web en 2025 y los bots maliciosos en 40%, séptimo año consecutivo de crecimiento, con las peticiones bloqueadas de bots impulsados por IA subiendo de 2 a 25 millones diarias.
Las medidas de bajo costo siguen sin aplicarse: filtros de referencia en analítica, reglas de tasa por país y por ASN en el CDN o WAF, desafío gestionado para rangos de nube ajenos al negocio, y separar en los tableros el tráfico verificado del total antes de decidir inversión en medios. → https://www.helpnetsecurity.com/2026/04/30/thales-ai-driven-bot-traffic-rise-report/
Para tu lista
Revisar esta semana
- Cláusulas de datos derivados y exclusión de entrenamiento en cada cuenta del equipo que toque código o investigación
- Tokens por tarea completada, por modelo y por configuración de agentes, antes de escalar orquestaciones
- Filtros de bots en analítica y reglas de tasa en el CDN, sobre todo en comercio electrónico
- Dimensionamiento de planes antes del 14 de septiembre
Herramientas
- GLM-5.3 en TokenRouter — endpoint gratuito temporal, útil para pruebas con OpenCode, Cline o Claude Code; no para producción
- ChatGPT Images — lienzo de la versión 2.5, con bocetos, plantillas y edición por comentarios
Lectura
- On the Navier–Stokes Millennium Prize Problem — el anuncio, con el detalle del método y las cifras de cómputo
- OpenAI's GPT-6 Astra on ARC-AGI-3 — el análisis de los dos arneses, con costos por corrida
- Red alert — Gary Marcus sobre la monitorabilidad del razonamiento
- Bad Bot Report 2026 — Imperva/Thales, cifras completas por industria
Para agendar El 13 de septiembre termina el nivel promocional de cuotas semanales. Sigue siendo la única fecha dura del calendario.