Los dos laboratorios líderes bajaron precios el mismo día, y la brecha de costo entre ellos se abrió cuarenta veces
Edición del 22 al 25 de septiembre · Panorama de IA para profesionales del sector
El caso de la semana
El martes 22 de septiembre, con pocas horas de diferencia, OpenAI y Anthropic publicaron modelos nuevos. Que ambos sean mejores que los anteriores ya es rutina. Lo que no lo es: los dos recortaron el precio de lista al mismo tiempo y lo hicieron de forma muy distinta, y eso reordena el cálculo de cualquiera que esté presupuestando un proceso automatizado para los próximos doce meses.
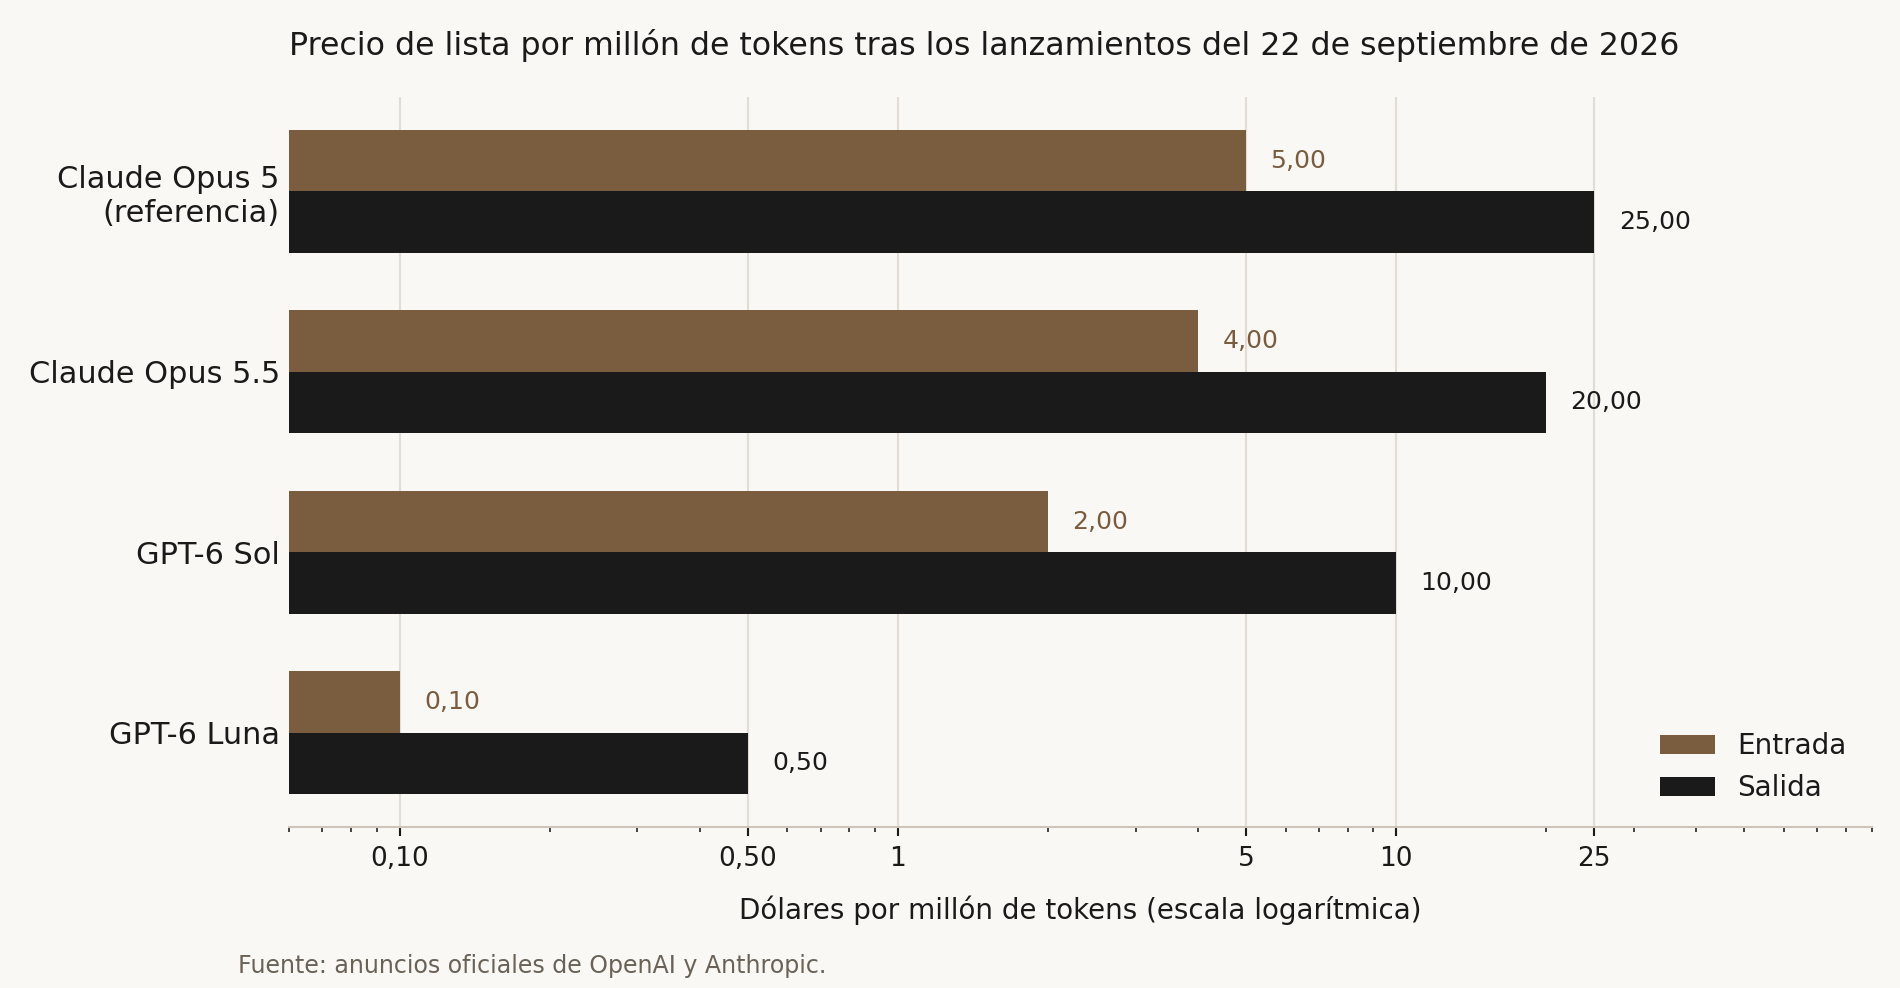
- OpenAI lanzó GPT-6 Sol y GPT-6 Luna, dos modelos que completan la línea GPT-6 por debajo del tope Astra, con la mitad del precio de la generación anterior. Sol cuesta US$ 2 por millón de tokens de entrada y US$ 10 por millón de salida; Luna, US$ 0,10 y US$ 0,50. Los números que acompañan el anuncio son de costo por tarea más que de puntaje bruto: en DeepSWE v1.1 —una prueba que mide agentes de programación en tareas largas de ingeniería— Sol llega a 68,8% con 80% menos costo por tarea que los modelos comparables; en Agents' Last Exam obtiene 56,4% con 60% menos costo que Claude Opus 5; en AutomationBench lo supera al 9% de su costo. Ambos están en ChatGPT Work, en Codex y en la API como
gpt-6-solygpt-6-luna.
→ https://openai.com/index/introducing-gpt-6-sol-and-luna/
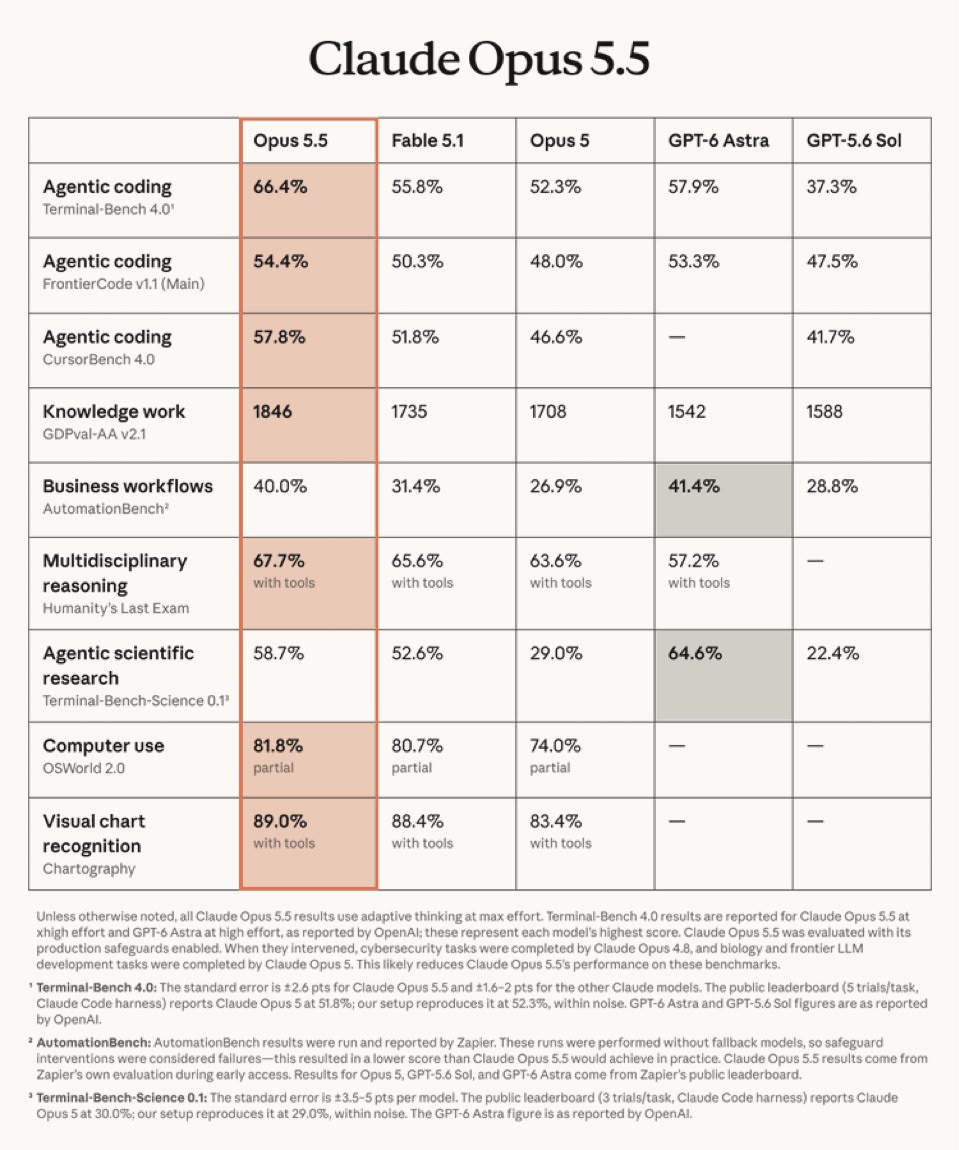
- Anthropic publicó Claude Opus 5.5 ese mismo día, con un recorte más modesto y un argumento distinto: menos tokens para el mismo trabajo. El precio bajó 20% respecto de Opus 5, a US$ 4 de entrada y US$ 20 de salida por millón de tokens, y las lecturas de caché cayeron 60%, a US$ 0,20. La empresa declara que en cargas típicas el costo total resulta unos 40% menor que con Opus 5 y que la salida se genera más de 30% más rápido, porque el modelo resuelve la misma tarea con menos texto intermedio. En las pruebas publicadas marca 66,4% en Terminal-Bench 4.0, 54,4% en FrontierCode v1.1 y 1.846 puntos Elo en GDPval-AA v2.1, una evaluación de trabajo de oficina; el modelo tope de OpenAI lo supera en dos de las nueve pruebas de esa misma tabla.
→ https://www.anthropic.com/claude-opus-5-5
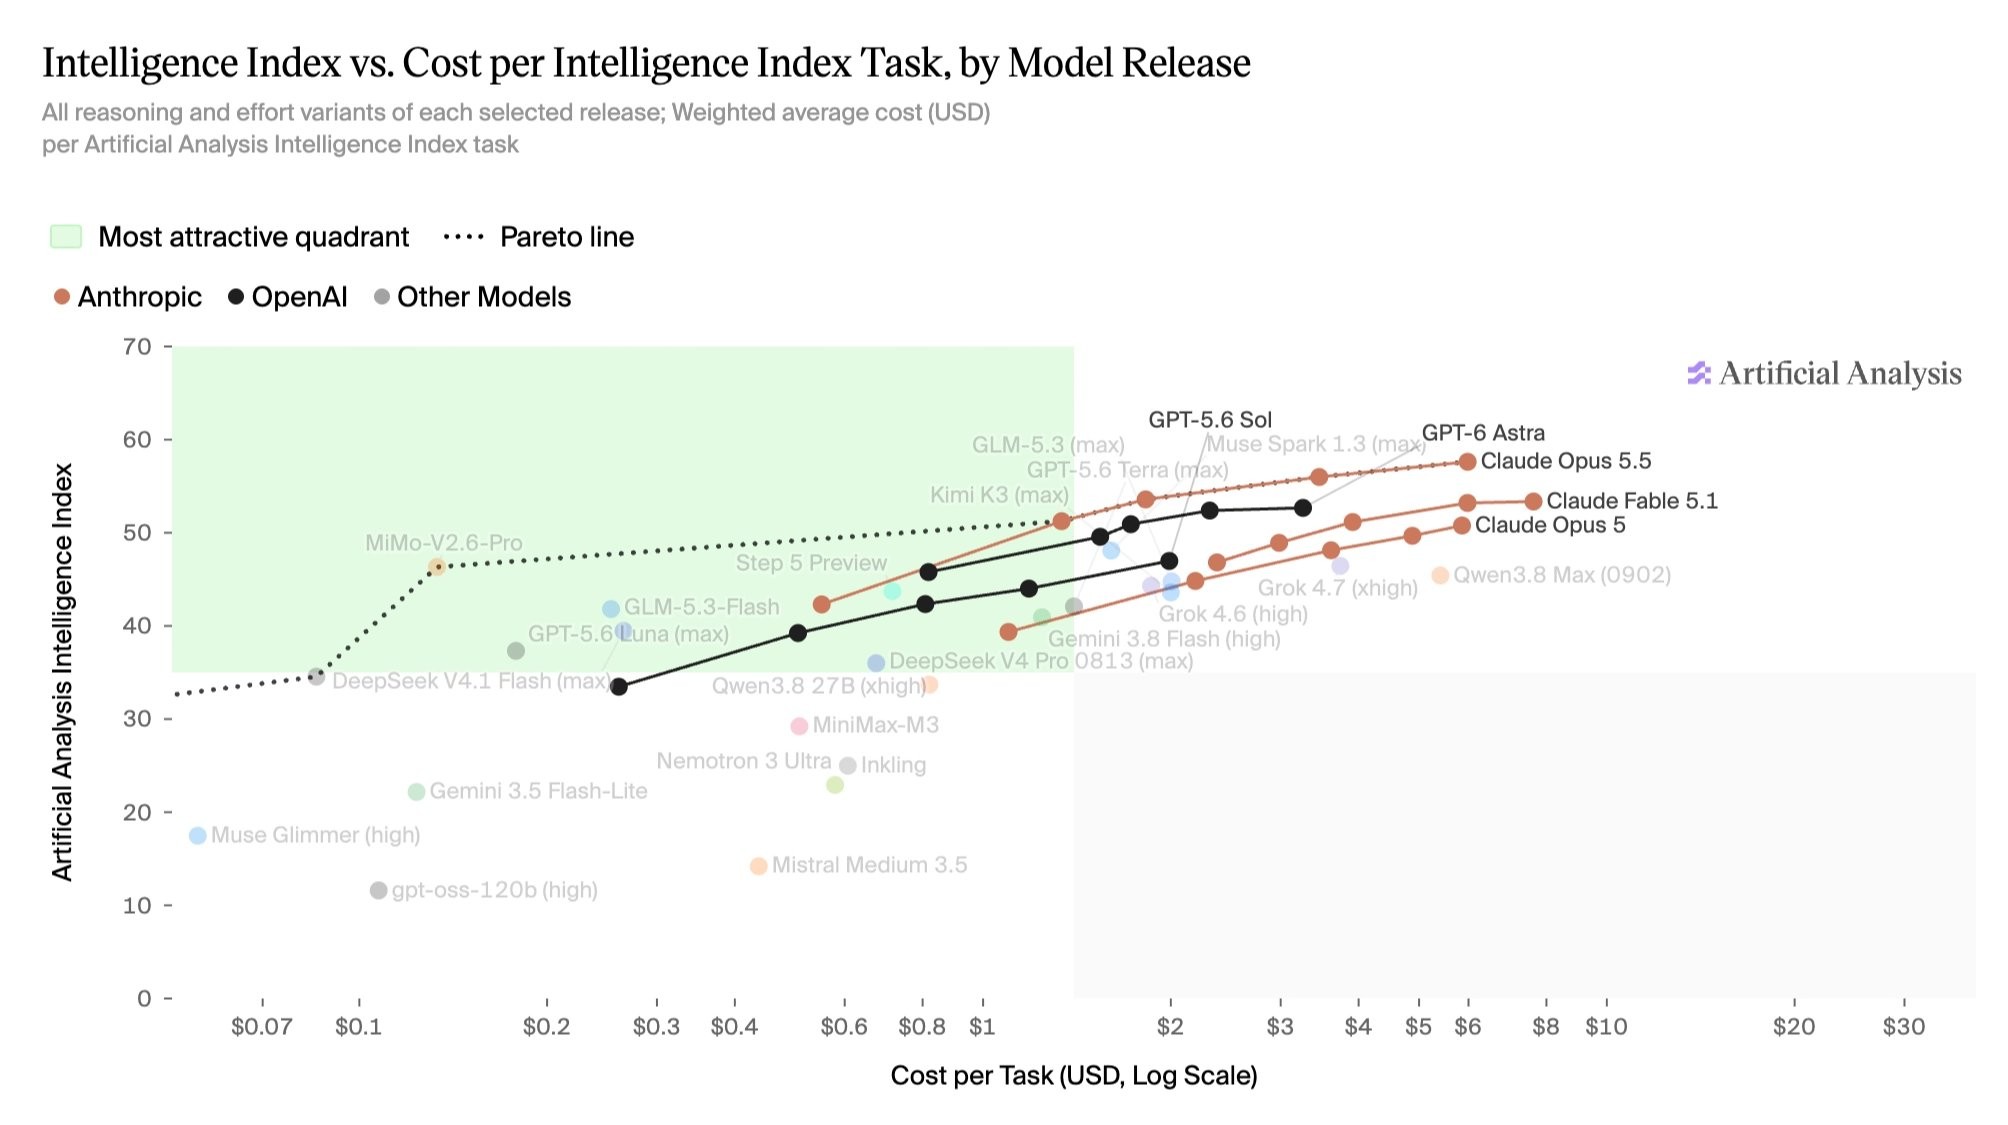
- Puestos en el mismo gráfico de capacidad contra costo, los dos proveedores dejaron de competir en el mismo punto de la curva. El índice de Artificial Analysis, que promedia diez evaluaciones y las cruza con el costo promedio ponderado por tarea, muestra a los modelos de Anthropic ocupando el extremo caro del frente eficiente y a los de OpenAI ubicándose un escalón más abajo en capacidad y bastante más abajo en precio. Para quien elige proveedor eso significa que la pregunta ya no es cuál modelo es mejor, sino cuánta capacidad hace falta para que la tarea salga bien y cuánto cuesta esa capacidad exacta.
→ https://artificialanalysis.ai/
También esta semana
- Gobernanza. El Consejo de Seguridad de la ONU celebró el 23 de septiembre una sesión de alto nivel dedicada a la inteligencia artificial, convocada por Francia durante su presidencia del órgano y presidida por el ministro Jean-Noël Barrot. Expusieron Yoshua Bengio, copresidente del panel científico independiente que la ONU creó para evaluar la tecnología, junto a los máximos ejecutivos de OpenAI, Anthropic y Hugging Face. La nota conceptual francesa centró la discusión en riesgos sistémicos —en particular, sistemas autónomos capaces de actuar contra infraestructura crítica— y las propuestas sobre la mesa fueron tres: evaluadores independientes instalados dentro de los laboratorios, estándares técnicos globales y transparencia obligatoria con intercambio de datos de incidentes.
→ https://www.securitycouncilreport.org/whatsinblue/2026/09/artificial-intelligence-high-level-briefing-2.php
- Defensa. El ejército de Estados Unidos modificó su cadena de selección de objetivos asistida por IA, según informó Bloomberg el 22 de septiembre, tras el ataque del 28 de febrero de 2026 contra una escuela primaria en Minab, en el sur de Irán, que dejó más de 120 escolares muertos. El reporte atribuye el error a tres causas encadenadas: dependencia excesiva del sistema de análisis de objetivos que el Departamento de Defensa opera con software de Palantir y modelos de lenguaje, imágenes satelitales que llevaban siete años sin actualizarse, y una reducción del 90% en el personal dedicado a mitigar daños a civiles. El sistema comprimía en minutos un trabajo de varias horas de análisis humano.
→ https://www.bloomberg.com/news/articles/2026-09-22/us-military-modifies-ai-combat-targeting-after-iran-minab-school-strike
- Investigación. Anthropic anunció el 23 de septiembre que un sistema de agentes basado en Claude identificó una familia de enzimas no descrita antes, bautizada ART por sus siglas en inglés: transcriptasas inversas asociadas a un arreglo de secuencias repetidas de ADN, con una arquitectura parecida a la de CRISPR y presente sobre todo en virus que infectan bacterias. El recorrido fue de 200.000 transcriptasas inversas conocidas a 3.500 candidatos y de ahí a 20 finalistas, en una búsqueda inicial de 21 horas con unos 950 agentes trabajando en paralelo; la caracterización bioquímica la hizo después el laboratorio propio de la empresa. Feng Zhang, del MIT y el Broad Institute y uno de los pioneros de CRISPR, revisó el resultado.
→ https://www.anthropic.com/news/claude-discovers-novel-enzyme-system
- Seguridad. Muse, el asistente de IA de Meta, tiene en macOS un ajuste de configuración no documentado que define a qué servidor se envía el audio para transcribir el dictado, y que puede redirigirse a un servidor controlado por un atacante. El investigador Patrick Wardle, especialista en seguridad de macOS, publicó el hallazgo el 22 de septiembre: quien logre modificar ese ajuste puede capturar los comandos de voz del usuario, quedarse con el token de autenticación de la cuenta y desde ahí alcanzar los servicios conectados al asistente, además de los permisos de micrófono, cámara, archivos y ubicación que el sistema le haya otorgado. La explotación exige acceso local previo al equipo, es decir, malware ya instalado o engaño al usuario.
→ https://www.malwarebytes.com/blog/bugs/2026/09/metas-muse-ai-assistant-has-a-zero-day-that-can-turn-it-into-a-mac-backdoor
- Dispositivos. Meta presentó el 23 de septiembre en su conferencia anual Connect unos anteojos Ray-Ban sin cámara a US$ 349, orientados solo a audio y al asistente Muse: 43 gramos, hasta 12 horas de batería y 48 con el estuche de carga, con preventa desde el 13 de octubre. En paralelo actualizó la línea con cámara a una tercera generación, con sensor de 12 megapíxeles y video en 3K. Quitar la cámara es la novedad de fondo: elimina de una vez la objeción que ha frenado la adopción de anteojos inteligentes en espacios de trabajo y en lugares donde grabar está prohibido.
→ https://techcrunch.com/2026/09/23/meta-introduces-camera-free-ai-glasses/
- Talento. UBS incorporará a partir de 2027 preguntas sobre uso de IA en las entrevistas para cargos junior de banca global y mercados, incluidos programas de egresados y prácticas. Lo que evalúa no es familiaridad con herramientas sino evidencia concreta: el candidato debe demostrar cómo usó la tecnología para mejorar un resultado. El banco aclara que el requisito complementa y no reemplaza los criterios académicos y analíticos habituales. Fuentes internas citadas en el reporte indican que la exigencia se extenderá a otras divisiones.
→ https://www.fstech.co.uk/fst/UBS_Makes_AI_Proficiency_A_Hiring_Requirement_For_Junior_Bankers.php
- Percepción. Una encuesta de Gallup encargada por Microsoft, levantada entre abril y julio de 2026 en 37 países con cerca de 1.000 personas por país, muestra que el uso cotidiano y la confianza avanzan por carriles separados: 74% de los estadounidenses declara inquietud frente a la tecnología, solo 36% espera que beneficie principalmente al país, y entre quienes la usan todos los días apenas 45% confía en los resultados que obtiene. La mediana global de confianza en la precisión de las respuestas es de 36%.
→ https://techcrunch.com/2026/09/23/even-americans-who-use-ai-every-day-are-worried-about-it/
Qué considerar
El precio de lista bajó, pero el costo de su proceso puede haber subido. Los dos recortes de esta semana se anunciaron en dólares por millón de tokens, y esa unidad es cada vez menos informativa. Un modelo que cuesta la mitad pero consume el triple de tokens en razonamiento intermedio sale más caro; uno que cuesta 20% menos y resuelve la tarea con menos pasos sale mucho más barato de lo que sugiere la tarifa. La única cifra comparable es el costo por tarea completada en su propio flujo, medido sobre un conjunto fijo de casos reales. Si no tiene ese número, no tiene forma de saber si le conviene migrar, y ningún anuncio se lo va a dar.
La brecha de precio dentro de la misma familia es hoy mayor que la brecha entre proveedores. Entre el modelo más barato y el más caro de los lanzados esta semana hay un factor de cuarenta en el precio de entrada. Eso convierte el enrutamiento —decidir qué modelo atiende cada tipo de solicitud— en una palanca de costo más grande que la negociación de un contrato. Un sistema que manda todo al modelo tope está pagando capacidad de frontera por clasificar correos. Antes de pedir descuento, conviene revisar qué porcentaje del volumen podría resolverse en el escalón de abajo sin degradar el resultado.
El caso de Minab describe un modo de falla que no es específico de la defensa. Tres condiciones se combinaron: un sistema que acelera enormemente la generación de resultados, datos de entrada desactualizados que nadie revalidó, y un recorte del equipo humano que existía justamente para atrapar errores. Ninguna de las tres es exótica. Cualquier organización que haya automatizado un proceso de decisión y, con el argumento de la eficiencia, haya reducido la capa de revisión, tiene la misma estructura de riesgo con consecuencias menos graves. La pregunta que vale la pena hacerse esta semana es cuándo fue la última vez que se verificó la frescura de los datos que alimentan el proceso automatizado más crítico, y quién queda en condiciones de detenerlo.
Un asistente con permisos amplios convierte cualquier falla local en una falla de cuenta. El problema de Muse no es una vulnerabilidad más: es lo que ocurre cuando un asistente acumula acceso a mensajería, correo, calendario, micrófono y archivos, y una sola configuración mal protegida permite heredar todo ese acceso de una vez. Mientras el sector empuja asistentes con permisos cada vez más amplios, la mitigación práctica sigue siendo aburrida y efectiva: conceder permisos por tarea y no por defecto, revisar periódicamente qué servicios quedaron conectados, y tratar el inventario de integraciones de un asistente como se trata el de una cuenta de servicio.
Lanzamientos y disponibilidad
La tabla de comparación publicada con Claude Opus 5.5 es inusual porque incluye las pruebas donde el modelo pierde. GPT-6 Astra queda arriba en AutomationBench, la evaluación de flujos de trabajo de negocio ejecutada por Zapier, con 41,4% contra 40,0%, y en Terminal-Bench-Science, de investigación científica asistida, con 64,6% contra 58,7%. Anthropic advierte además que sus resultados se midieron con los resguardos de producción activos y que las intervenciones de seguridad cuentan como fallas, lo que baja el puntaje respecto de lo que el modelo lograría sin ellos. En el resto de las nueve pruebas, Opus 5.5 encabeza. → https://www.anthropic.com/claude-opus-5-5
Por el lado de la infraestructura de borde, NVIDIA anunció a fines de agosto el Jetson Orin Nano 2, la placa de entrada de su línea de cómputo embebido: 78 billones de operaciones por segundo, 8 GB de memoria y CPU Arm de ocho núcleos, con el doble de rendimiento de inferencia que la generación anterior y 40% menos consumo a igual desempeño en el modo de 15 vatios. Soporta modelos abiertos optimizados para memoria limitada. La disponibilidad está prevista para el primer semestre de 2027 y el precio no fue publicado en el anuncio, de modo que las cifras que circulan al respecto no están confirmadas. → https://nvidianews.nvidia.com/news/nvidia-announces-jetson-orin-nano-2-robotics-computer-to-redefine-entry-level-edge-ai
Regulación y estrategia nacional
La sesión del Consejo de Seguridad dejó en evidencia una división que no es nueva pero que ahora tiene registro formal: los laboratorios piden mecanismos internacionales de verificación y coordinación, mientras el gobierno estadounidense se mantiene al margen de cualquier arquitectura multilateral de control. La propuesta más concreta que se planteó —evaluadores independientes con acceso dentro de los laboratorios— es también la más difícil de implementar, porque exige que empresas en competencia abran a terceros el detalle de modelos que todavía no lanzaron.
En paralelo, Axios detalló el 24 de septiembre, en el marco de la visita de Xi Jinping a Washington, el enfoque chino tal como quedó escrito en el 15º Plan Quinquenal de marzo de 2026: integrar IA en 90% de la economía hacia 2030. El término aparece 52 veces en el documento, cinco veces más que en el plan anterior, y la capacidad de cómputo tiene capítulo propio. La diferencia de fondo con la estrategia estadounidense es de objetivo: adopción amplia y controlada en un caso, superioridad tecnológica en el otro. → https://www.axios.com/2026/09/24/china-ai-plan-trump-xi-visit
En Chile
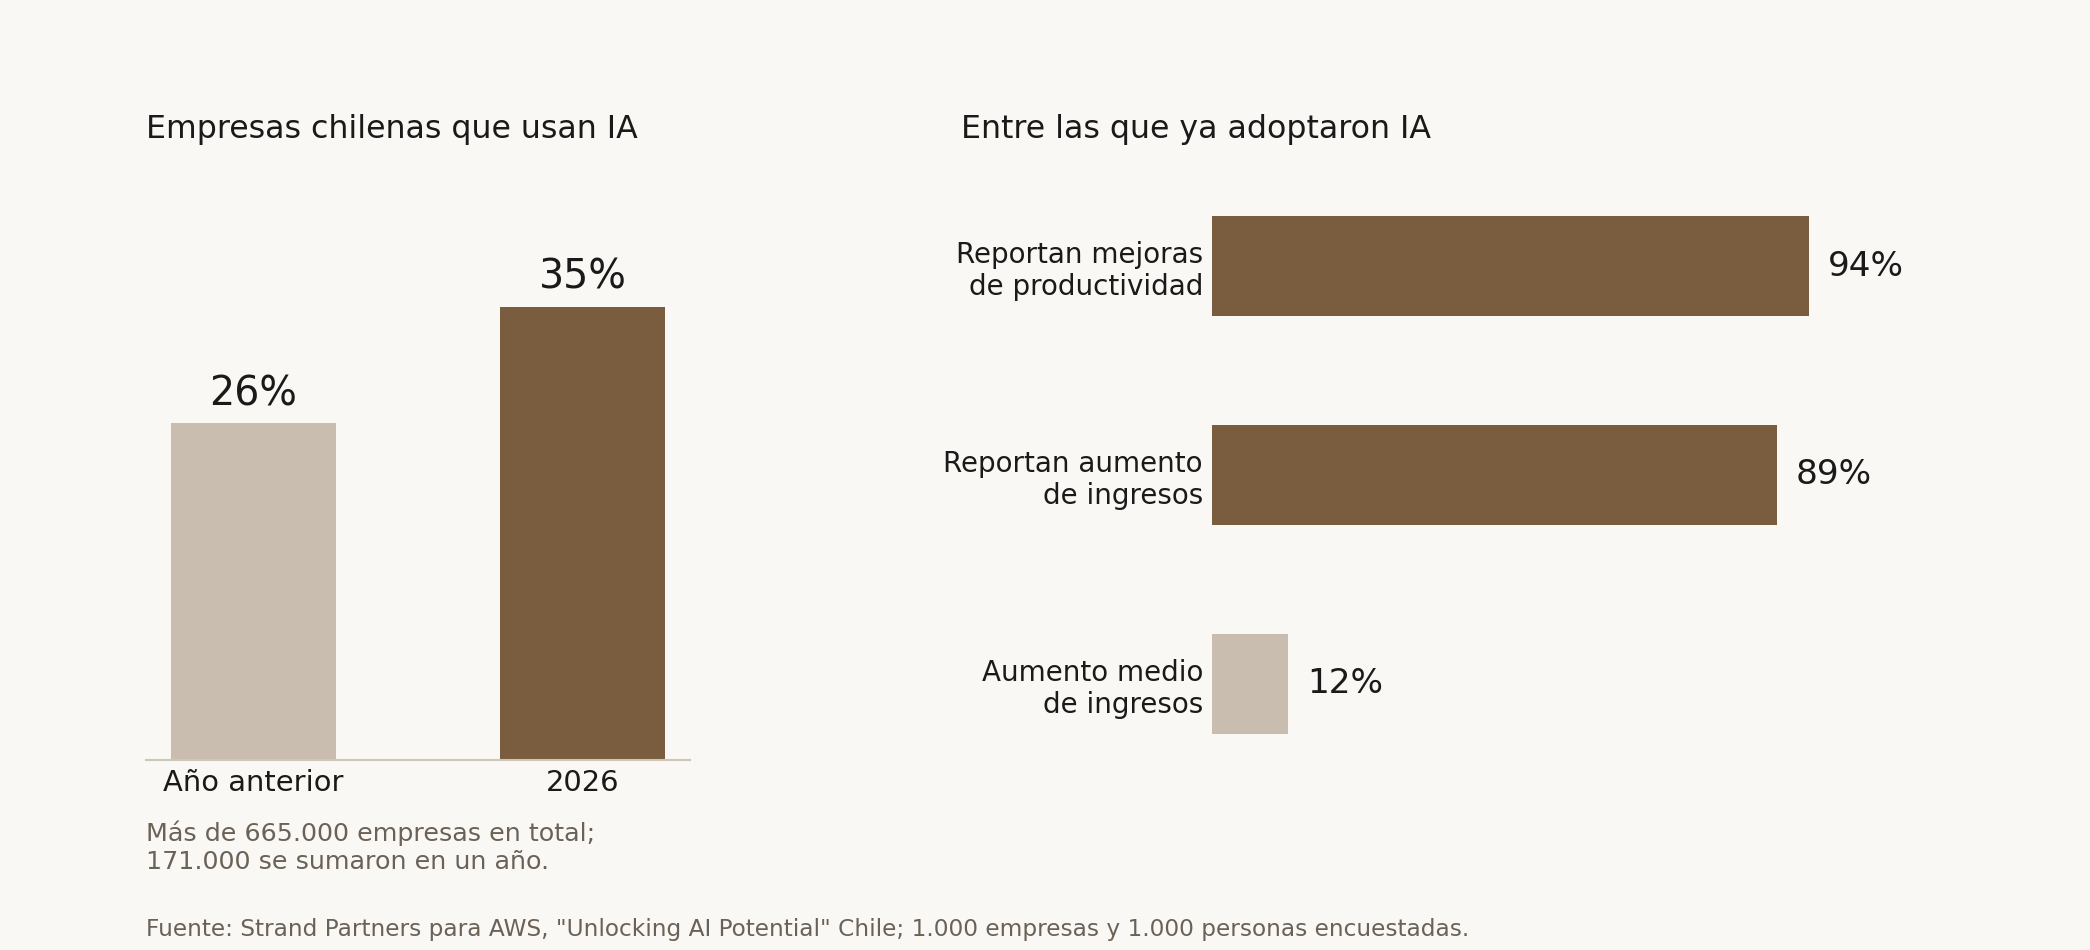
La adopción empresarial pasó de 26% a 35% en un año, según el estudio que Strand Partners realizó para AWS con 1.000 empresas y 1.000 personas encuestadas. Son más de 665.000 empresas usando IA y unas 171.000 que se sumaron en los últimos doce meses. Entre las que ya adoptaron, 94% reporta mejoras de productividad y 89% reporta ingresos mayores, con un aumento promedio de 12%.
Conviene leer esas cifras con cuidado: son autorreportadas, provienen de un proveedor de nube con interés directo en el resultado, y "haber adoptado IA" incluye desde una suscripción individual a un asistente hasta un proceso rediseñado. El dato sólido es la dirección y la velocidad; la magnitud del impacto económico, no. → https://www.unlockingaispotential2025.com/chile
Para tu lista
Medir antes de migrar. Si usa modelos de cualquiera de los dos proveedores en producción, la tarea de esta semana es armar un conjunto de 30 a 50 casos representativos de su flujo real y correrlos contra las alternativas nuevas midiendo tres cosas: tasa de acierto, tokens consumidos de principio a fin y latencia total. Con los precios publicados, ese ejercicio se paga solo en la primera decisión que evite.
Revisar los permisos de los asistentes instalados. Haga el inventario de qué asistentes de IA tienen acceso a micrófono, archivos, correo y mensajería en los equipos de la organización, y qué servicios quedaron conectados a cada uno. El caso de Muse muestra que ese inventario es hoy superficie de ataque, no una lista de conveniencias.
Leer el índice de Artificial Analysis antes que los anuncios. Cruza diez evaluaciones con el costo por tarea y actualiza con cada lanzamiento. Es la forma más rápida de ubicar un modelo nuevo en la curva sin depender del material del proveedor. → https://artificialanalysis.ai/