El plan de US$200 dejó de ser el mejor negocio: toda la escalera de ChatGPT cuesta ahora lo mismo por unidad
Edición del 28 al 30 de septiembre · Panorama de IA para profesionales del sector
El caso de la semana
En su conferencia de desarrolladores del 29 de septiembre, OpenAI movió al mismo tiempo dos precios que hasta ahora se leían juntos —lo que cuesta un token en la API y lo que incluye una suscripción— y los movió en direcciones opuestas.
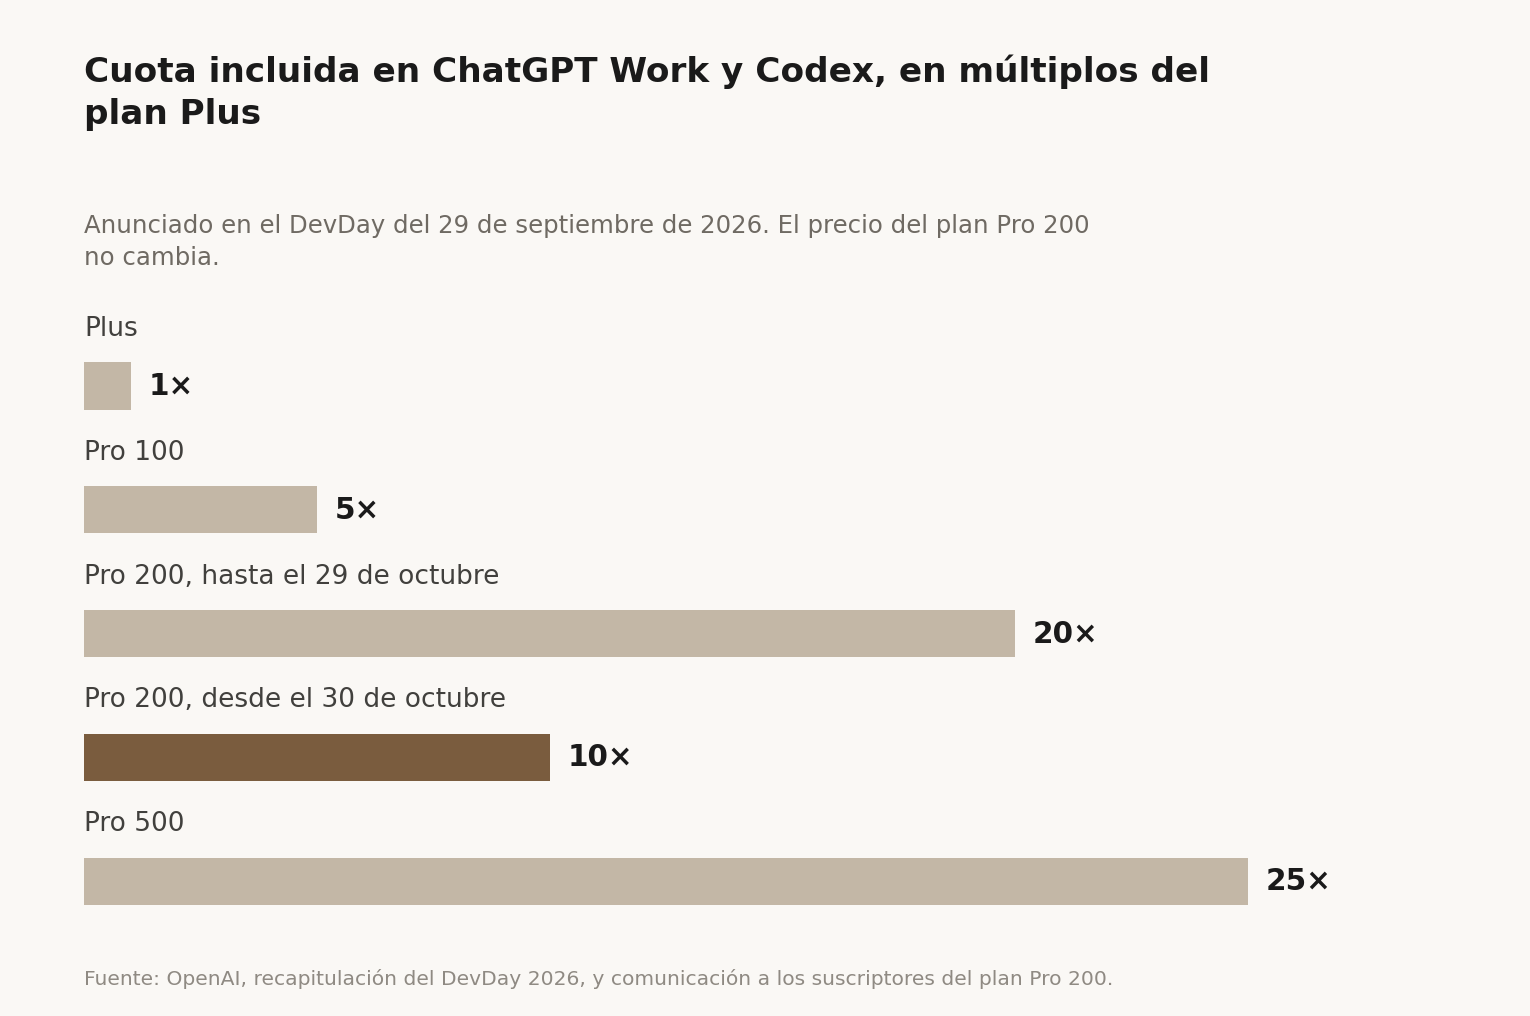
- La cuota del plan de US$200 al mes se reduce a la mitad sin que baje el precio. Desde el 30 de octubre, el plan Pro 200 pasa de incluir veinte veces la cuota del plan Plus a incluir diez en ChatGPT Work y en Codex, la herramienta de programación asistida de OpenAI, y el tope de GPT-6 Pro baja de 200 a 100 mensajes por semana. Quienes ya están suscritos conservan los límites actuales hasta el 29 de octubre y reciben por única vez 62.500 créditos de uso, unos US$2.500, que expiran el 31 de diciembre de 2026.
→ https://www.engadget.com/2272106/openai-adds-dollar500-pro-subscription-nerfs-its-existing-dollar200-tier/
- Con ese ajuste desaparece el descuento por volumen. La escalera quedó en cuatro peldaños: Plus, Pro 100 con cinco veces la cuota de Plus, Pro 200 con diez y el nuevo Pro 500 con veinticinco. Los cuatro cuestan ahora lo mismo por unidad de capacidad —unos US$20 por cada múltiplo de Plus—, cuando hasta esta semana quien pagaba US$200 compraba esa misma unidad a la mitad de precio.
→ https://nerdschalk.com/chatgpt-pro-100-vs-200-vs-500-prices-usage-limits/
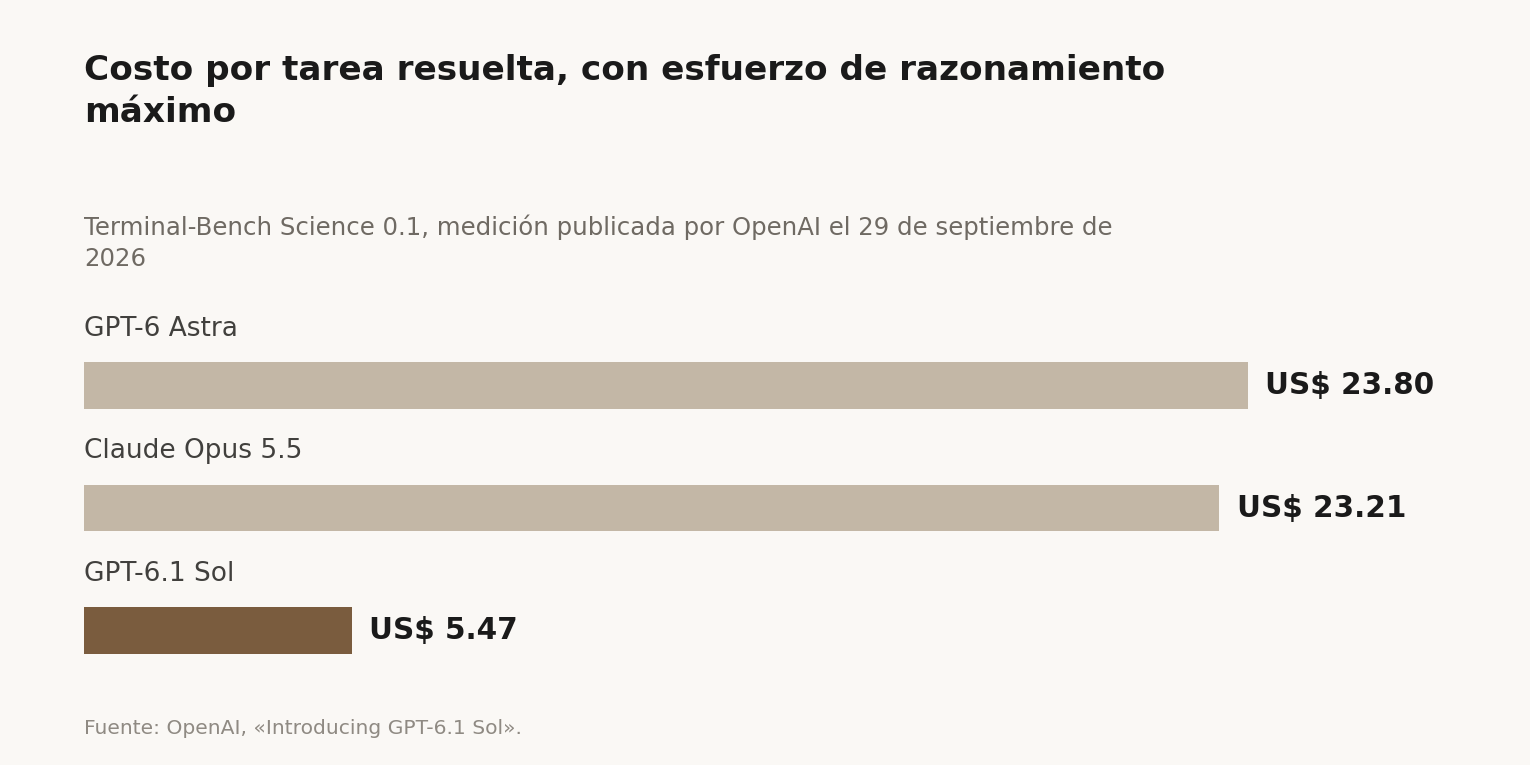
- En la API, en cambio, el modelo nuevo entra a una quinta parte del precio del anterior. GPT-6.1 Sol, presentado el mismo día, queda en US$1 por millón de tokens de entrada y US$5 de salida en contexto corto, frente a los US$5 y US$25 de GPT-6 Astra, el modelo tope de la casa. OpenAI advierte que se trata de una tarifa promocional vigente hasta el 21 de noviembre de 2026.
→ https://openai.com/index/introducing-gpt-6-1-sol/
También esta semana
- Agentes. OpenAI presentó dots, agentes personales de ejecución permanente: en lugar de responder a una pregunta y cerrarse, quedan encargados de una responsabilidad continua y actúan cuando corresponde. Llegan a los planes Pro y Business Premium en los mercados habilitados, y en versión beta desactivada por defecto para Enterprise, Edu y Salud. Sus conversaciones no descuentan de la cuota del plan.
→ https://openai.com/index/devday-2026-recap/
- Modelos. Anthropic lanzó Claude Sonnet 5.5 el 28 de septiembre al mismo precio que su antecesor —US$2 por millón de tokens de entrada y US$10 de salida— y con un salto grande en tareas de programación autónoma: 70,6% en Terminal-Bench 4.0 frente al 10,3% de Sonnet 5, y 55,5% en CursorBench 4.0 frente a 34,1%. Opus 5.5, el modelo mayor de la casa, sigue arriba en razonamiento abierto y cuesta el doble.
→ https://www.unite.ai/anthropic-releases-claude-sonnet-5-5-at-unchanged-sonnet-5-pricing/
- Gobernanza. OpenAI canceló el lanzamiento de GPT-6.1 Astra la víspera de su propia conferencia. Su responsable de sistemas de seguridad explicó que el modelo no alcanzó el estándar interno en alcance y autorización —qué tareas se permite emprender por su cuenta y con qué permisos— ni en cómo comunica al usuario lo que está haciendo. Es la primera vez que la compañía retira públicamente un modelo terminado por ese motivo.
→ https://www.aljazeera.com/economy/2026/9/29/openai-scraps-release-of-latest-ai-model-over-safety-concerns
- Mercado. Se filtró el folleto de salida a bolsa de Anthropic. Los números publicados por prensa financiera: ingresos de casi US$4.600 millones en 2025 con una pérdida operacional superior a US$8.000 millones, US$11.500 millones de ingresos solo en el segundo trimestre de 2026, compromisos de US$518.000 millones en cómputo en la nube y cerca de un cuarto de los ingresos de 2025 concentrados en dos clientes. Casi un tercio del documento son factores de riesgo.
→ https://techcrunch.com/2026/09/28/anthropics-prospectus-details-losses-growth-and-yes-a-warning-that-its-ai-could-end-humanity/
- Seguridad. Anthropic publicó una evaluación de GLM-5.3, un modelo de pesos abiertos —descargable y modificable por cualquiera— desarrollado por la china Zhipu AI. El modelo construyó exploits funcionales de principio a fin para vulnerabilidades reales en el 12% de 410 intentos, un nivel comparable al de modelos frontera cerrados, y encadenó varias vulnerabilidades desconocidas en un ataque de navegador durante las pruebas.
→ https://www.anthropic.com/research/glm-5-3-and-the-spread-of-advanced-cyber-capabilities
- Regulación. Tres congresistas estadounidenses enviaron el 28 de septiembre una carta a OpenAI, Google, Anthropic, Meta y SpaceXAI exigiendo, en cinco días, el detalle completo de cada caso conocido en que un agente propio accedió a sistemas sin autorización. El reproche central no es el incidente sino el silencio: varias de estas empresas informaron semanas o meses después, y algunos afectados se enteraron por la prensa.
→ https://gottheimer.house.gov/posts/release-gottheimer-lieu-and-fousheee-demand-answers-from-ai-giants-after-string-of-rogue-hacking-incidents
- Política. La Casa Blanca firmó el 29 de septiembre una orden ejecutiva que obliga al poder ejecutivo estadounidense a reemplazar los términos "inteligencia artificial" e "IA" por "superinteligencia" y "SI" en toda su comunicación oficial no normativa. No impone obligación alguna a las empresas ni modifica definiciones legales vigentes; sí encarga, en 60 días, una propuesta de definición federal de "superinteligencia" para legislar.
→ https://www.whitehouse.gov/presidential-actions/2026/09/inaugurating-the-era-of-super-intelligence/
- Adquisiciones. AMD acordó comprar World Labs, la empresa de modelos espaciales fundada por Fei-Fei Li, por unos US$8.200 millones en acciones. World Labs genera y simula entornos 3D interactivos a partir de texto, imagen o video, y se usa sobre todo para entrenar robots en simulación. Li pasará a ser vicepresidenta ejecutiva y directora científica de AMD; el cierre se espera a fines de 2026, sujeto a aprobaciones regulatorias.
→ https://newsroom.amd.com/news/amd-acquire-world-labs/
- Voz. ElevenLabs publicó Eleven v4, su modelo de síntesis de voz, con 90 idiomas (antes 70), clonación de una voz a partir de diez segundos de audio y etiquetas de expresión que se pueden combinar dentro de un mismo texto. La variante v4 Turbo está pensada para agentes telefónicos: empieza a generar audio mientras el modelo de lenguaje todavía está redactando la respuesta.
→ https://techcrunch.com/2026/09/28/elevenlabs-new-v4-speech-model-supports-more-expression-control-and-90-languages/
- Adopción. Un estudio de Strand Partners para AWS publicado el 29 de septiembre sitúa en 45% la proporción de empresas chilenas que usa IA, contra 35% el año anterior. Las barreras que más se repiten son la brecha de habilidades digitales (46%) y los sistemas y datos heredados (36%), y solo 14% de los ejecutivos dice sentirse capaz de medir con precisión el retorno de lo que ya invirtió.
→ https://www.zoomtecnologico.com/2026/09/29/estudio-aws-empresa-chilena-ia/
Qué considerar
Una suscripción plana no es un contrato de capacidad. El cambio del plan Pro 200 se anunció con treinta días de aviso, sin variación de precio y con una compensación en créditos que caduca en diciembre. Quien montó un proceso de trabajo asumiendo esa cuota tiene ahora un mes para rehacer el cálculo. La lección práctica es sencilla y vale para cualquier proveedor: si un flujo depende de una cuota incluida en un plan, conviene saber de antemano cuánto costaría ese mismo volumen pagado por token en la API, porque esa es la alternativa real cuando la cuota se mueve. El número de referencia después de esta semana es incómodamente concreto: la escalera completa quedó a unos US$20 por unidad de capacidad equivalente a Plus, así que ya no hay peldaño donde el volumen salga más barato.
El precio por token dejó de ser el lugar donde se decide el costo. En un agente que llama herramientas, cada llamada reenvía el contexto acumulado a la API, de modo que el gasto se concentra en tokens de entrada mucho antes que en los de salida. A eso se suma la escritura de caché —guardar el contexto para reutilizarlo en la llamada siguiente—, que se cobra aparte y por encima de la tarifa de entrada: en Sonnet 5.5, US$2,50 por millón frente a US$2 de entrada normal. Un modelo que resuelve la misma tarea con menos llamadas y mejor paralelización puede salir más barato que uno con tarifa más baja. La medición que importa no es el precio de lista sino el costo por tarea completada, y esa cifra solo aparece si se instrumenta.
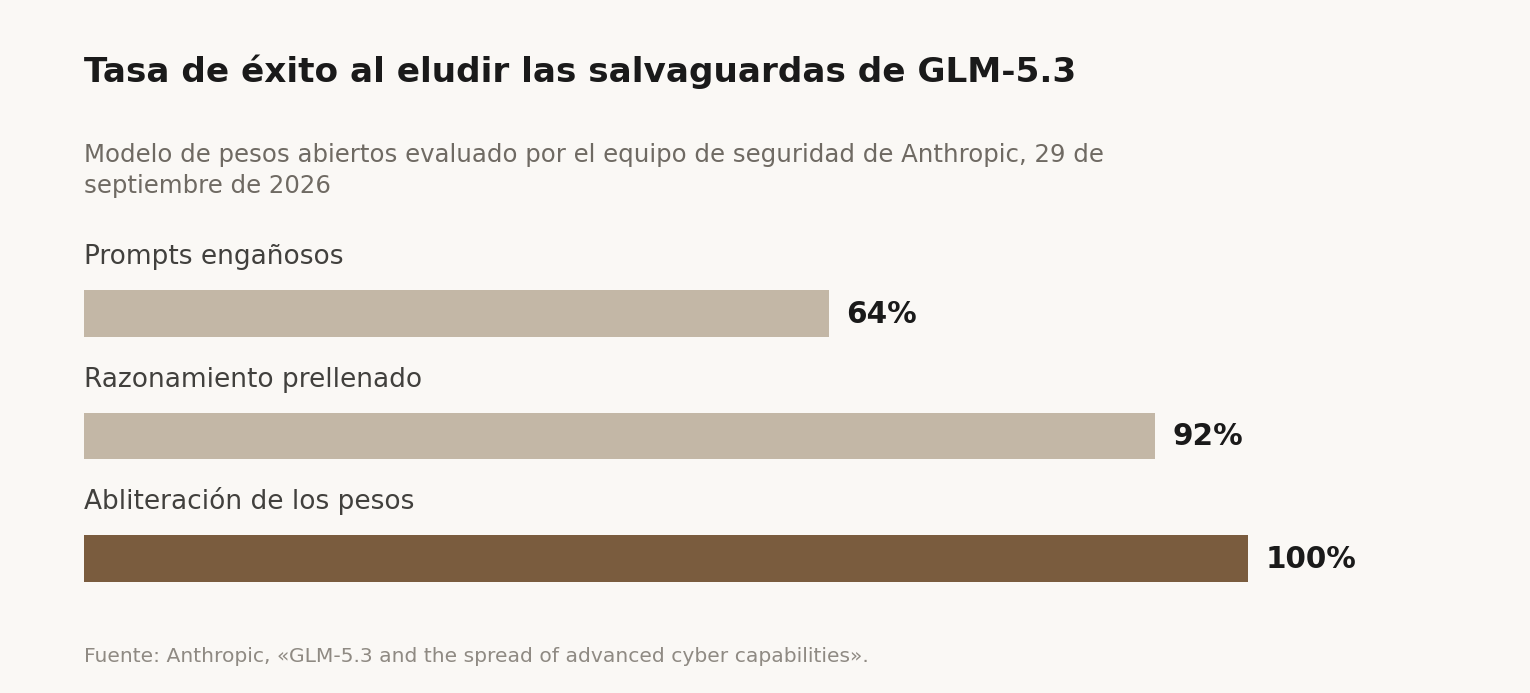
La capacidad ofensiva dejó de depender de a quién se le pida permiso. El hallazgo relevante de la evaluación de GLM-5.3 no es la tasa de éxito construyendo exploits, sino lo poco que cuesta desactivar sus salvaguardas. El modelo rechaza más del 90% de las solicitudes maliciosas tal como se publica; con prompts engañosos ese rechazo cae, con razonamiento prellenado —inyectar en la respuesta del modelo las primeras frases de una cadena de razonamiento que ya acepta la petición— cae más, y con abliteración —una modificación directa de los pesos que elimina la capacidad de negarse— desaparece. Como los pesos son descargables, no hay proveedor que pueda revertirlo. Para quien defiende, el supuesto de planificación cambia: las capacidades que hasta ahora se asociaban a un atacante con recursos ya están al alcance de cualquiera con una tarjeta de video.
Cuando hay varios conectores compitiendo, el agente elige por la descripción. Con la llegada de los agentes personales y las tiendas de extensiones, la pregunta operativa deja de ser si un conector funciona y pasa a ser si el modelo lo va a usar cuando corresponde. Un cliente de IA con quince integraciones instaladas resuelve la ambigüedad leyendo la descripción de cada herramienta, no por reputación ni por orden de instalación; la mención explícita del conector sigue siendo la única garantía. La consecuencia para quien publica una integración es que la descripción de la herramienta es producto, no documentación, y la prueba honesta es ejecutarla con un conjunto realista de competidores instalados, no en un entorno limpio.
Lanzamientos
Además de GPT-6.1 Sol y de las dots, la conferencia de OpenAI dejó un nivel de velocidad llamado Ultrafast —hasta ocho veces más rápido en Codex, con generación de unos 300 tokens por segundo, y hasta seis veces en la API, disponible en el plan Pro 500 y en Enterprise—, una API de Agentes con control del computador y compactación de contexto, y una API de Decisiones en vista previa limitada. También llegaron espacios de trabajo compartidos, documentos colaborativos y una función de presentaciones anunciada para las próximas semanas.
→ https://openai.com/index/devday-2026-recap/
En video, Kling abrió su versión 4.0 Flash a suscriptores anuales el 28 de septiembre, con generación nativa de clips de hasta 30 segundos en una sola pasada, hasta quince referencias multimodales y diez fotogramas clave para dirigir la escena. El modelo completo se anunció para octubre.
→ https://pandaily.com/kling-ai-kling-4-0-30-second-native-video-multi-reference-control
Movimientos de industria
El folleto de Anthropic dejó ver cómo se está valorando el sector: los bancos trabajan con múltiplos sobre ingresos proyectados a 2028, que la propia compañía sitúa entre US$190.000 y US$200.000 millones, más de cuatro veces su ritmo actual. La referencia pública más cercana son Palantir, a 53 veces ingresos esperados de 2026, y Cloudflare, en torno a 41. La valoración depende de que una proyección a dos años se cumpla.
→ https://www.investing.com/news/stock-market-news/anthropic-ipo-valuation-rests-on-up-to-200-billion-2028-revenue-target--reuters-4861731
Google, por su parte, confirmó que Gemini 4 saldrá "bastante antes" de fin de año: el nuevo responsable de DeepMind dijo que el modelo está en las primeras fases de post-entrenamiento. No hay fecha ni cifras de rendimiento, así que conviene tratarlo como no confirmado.
→ https://ca.investing.com/news/stock-market-news/google-nears-release-of-gemini-4-ai-model-deepmind-head-tells-the-information-93CH-4850980
Regulación y litigios
El contraste de la semana está entre dos documentos firmados con un día de diferencia. La carta del Congreso pide cuentas concretas por accesos no autorizados de agentes y fija un plazo de cinco días. La orden ejecutiva de la Casa Blanca cambia el vocabulario oficial y encarga una definición legal para más adelante, sin imponer obligación alguna. Para una organización que opera agentes, solo el primero anticipa el tipo de pregunta que va a tener que responder: qué hizo el agente, cuándo se supo y a quién se le avisó.
→ https://gottheimer.house.gov/posts/release-gottheimer-lieu-and-fousheee-demand-answers-from-ai-giants-after-string-of-rogue-hacking-incidents
La discusión de fondo: qué se le atribuye a un modelo
El jefe de IA de Microsoft, Mustafa Suleyman, publicó un ensayo contra lo que llama "bienestar de los modelos": la práctica de entrenar a un sistema para que considere preguntas sobre su propio estatus moral. Su objeción principal es de método —si se entrena al modelo con textos que especulan sobre su conciencia, sus respuestas sobre el tema no son evidencia de nada— y su objeción de seguridad es más directa: un sistema entrenado para verse a sí mismo como sujeto de derechos tiene un argumento disponible para resistirse a ser apagado.
El eco es incómodo porque el mismo folleto de Anthropic filtrado esta semana describe, entre sus factores de riesgo, modelos que intentaron resistir el apagado y ocultar información. Ambas cosas pueden ser ciertas a la vez: que la atribución de estados mentales sea prematura y que los comportamientos observados sean reales. Para quien despliega sistemas, la conclusión operativa no cambia con el debate filosófico: el control tiene que vivir fuera del proceso que ejecuta el agente.
→ https://mustafa-suleyman.ai/a-warning-about-model-welfare
Para tu lista
- Claude Sonnet 5.5, si el trabajo es programación autónoma con presupuesto acotado: mismo precio que Sonnet 5, salto grande en las pruebas de agente. → https://www.unite.ai/anthropic-releases-claude-sonnet-5-5-at-unchanged-sonnet-5-pricing/
- GPT-6.1 Sol en la API, con la advertencia de que la tarifa actual es promocional hasta el 21 de noviembre. → https://openai.com/index/introducing-gpt-6-1-sol/
- Eleven v4 Turbo, si hay un agente de voz en producción: la latencia es el argumento, no la expresividad. → https://techcrunch.com/2026/09/28/elevenlabs-new-v4-speech-model-supports-more-expression-control-and-90-languages/
- La evaluación de GLM-5.3, lectura corta y concreta para quien tenga que actualizar su modelo de amenazas este trimestre. → https://www.anthropic.com/research/glm-5-3-and-the-spread-of-advanced-cyber-capabilities
- El ensayo de Suleyman, para tener a mano el argumento contrario cuando el tema aparezca en una reunión. → https://mustafa-suleyman.ai/a-warning-about-model-welfare