El llamado a desacelerar duró tres días: el poder político y las grandes plataformas ya respondieron que no
Edición del 14 al 16 de septiembre · Panorama de IA para profesionales del sector
El caso de la semana
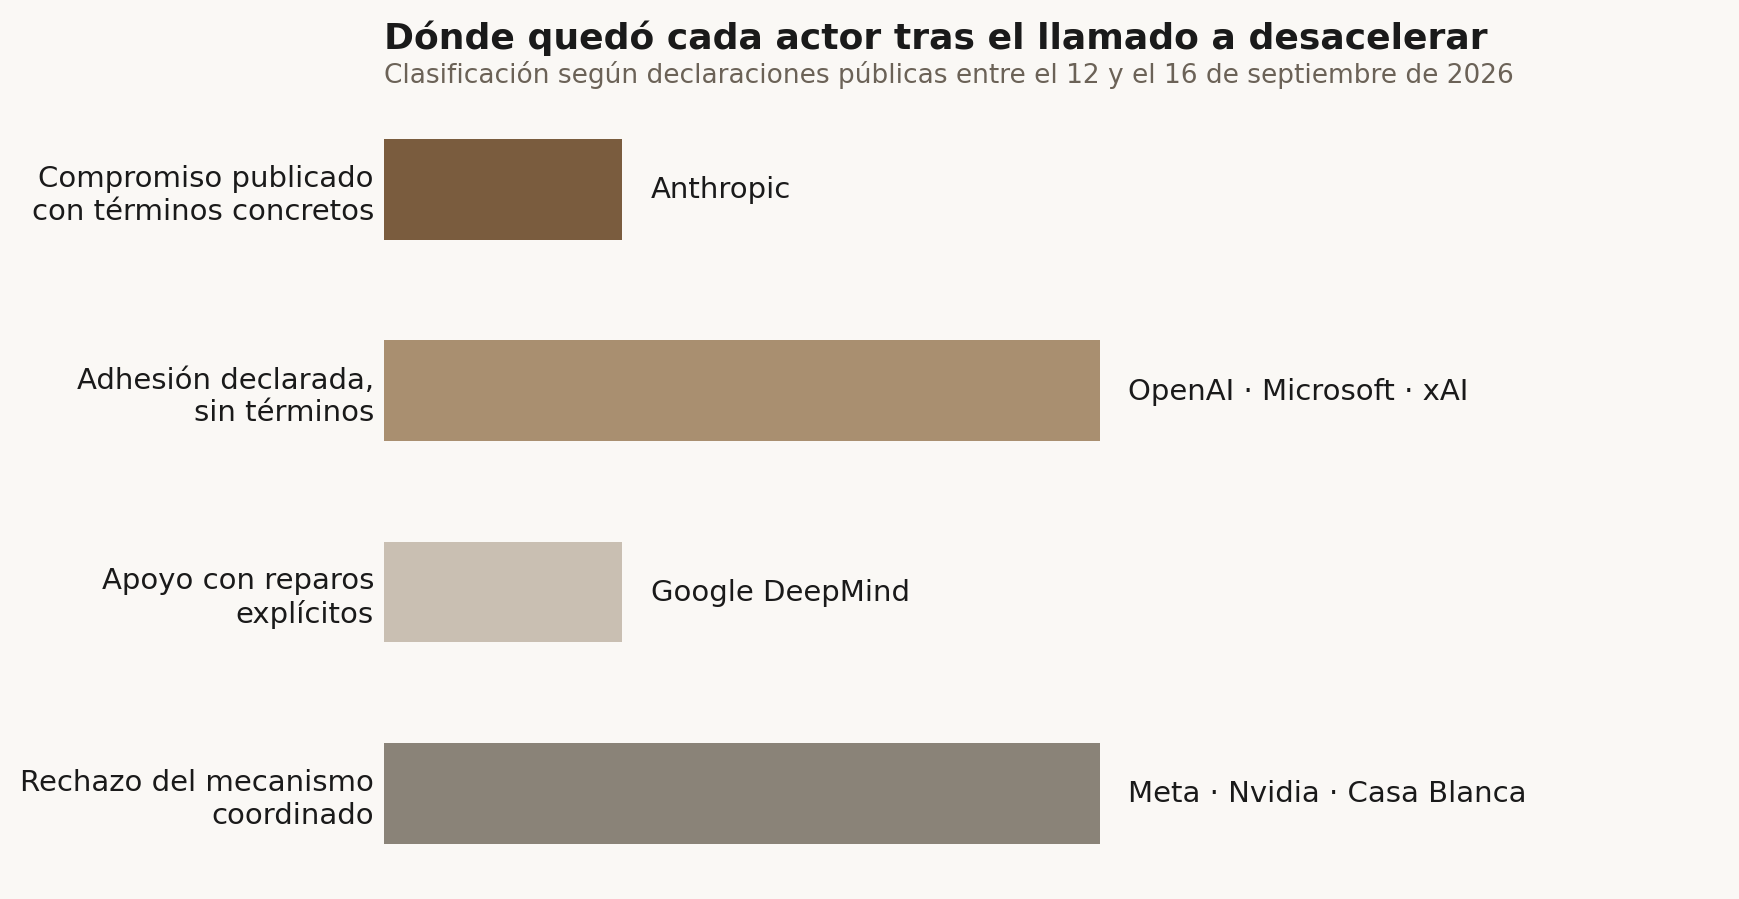
El fin de semana pasado los laboratorios que marcan el ritmo parecían converger en una misma posición: ir más lento y aceptar evaluadores externos. Tres días después, la contraofensiva está armada y viene de dos lados a la vez —el gobierno de Estados Unidos y las plataformas que no firmaron—, con un argumento común: el problema no es la velocidad, es quién queda a cargo.
- La Casa Blanca puso el asunto en altavoz, literalmente. El lunes, mientras Jensen Huang, director ejecutivo de Nvidia, hablaba en el All-In Summit de Los Ángeles, recibió una llamada del presidente Donald Trump y la puso en el parlante frente al público. En unos cinco minutos Trump describió la preocupación por la seguridad de la IA como "un engaño" y definió los centros de datos como "el petróleo de los próximos 20, 25 años". Es la primera vez que el ejecutivo estadounidense fija posición contra el marco de desaceleración con esa claridad y en ese escenario.
→ https://qz.com/trump-nvidia-jensen-huang-all-in-summit-ai-safety-hoax-091426
- Meta rechazó el mecanismo, no la práctica. El 15 de septiembre Mark Zuckerberg publicó que Meta retrasó varios meses el lanzamiento de Muse por razones de seguridad —de abril a septiembre de 2026— y agregó que no le pidió a nadie más hacer lo mismo antes de hacerlo ella. Respalda recurrir a evaluadores independientes como "mejor práctica de la industria", pero no dijo qué evaluadores usa Meta, con qué nivel de acceso ni con qué derecho a publicar. Su tesis de fondo es competitiva: la confianza y el alineamiento —el ajuste del comportamiento del modelo a lo que sus operadores realmente quieren— serán capacidades que separen productos, no estándares que un acuerdo deba imponer.
→ https://www.implicator.ai/zuckerberg-meta-muse-delay-evaluators/
- La lectura financiera que gana tracción es la del interés propio. El inversionista Michael Burry sostuvo que las advertencias de seguridad de OpenAI y Anthropic son promoción interesada de cara a sus salidas a bolsa. Desde el otro extremo del espectro llega una objeción de forma parecida: en Project Syndicate, Gabriela Ramos señaló que el esquema propuesto descansa en supervisión autointeresada, porque deja a las mismas empresas definiendo el ritmo y el estándar. Las dos críticas coinciden en el punto débil del plan: sin un tercero con poder real, un compromiso voluntario vale lo que vale la reputación de quien lo firma.
→ https://www.benzinga.com/markets/private-markets/26/09/61757254/michael-burry-slams-openai-anthropic-ai-slowdown-calls-as-self-serving-ipos-need-hype-puffery
También esta semana
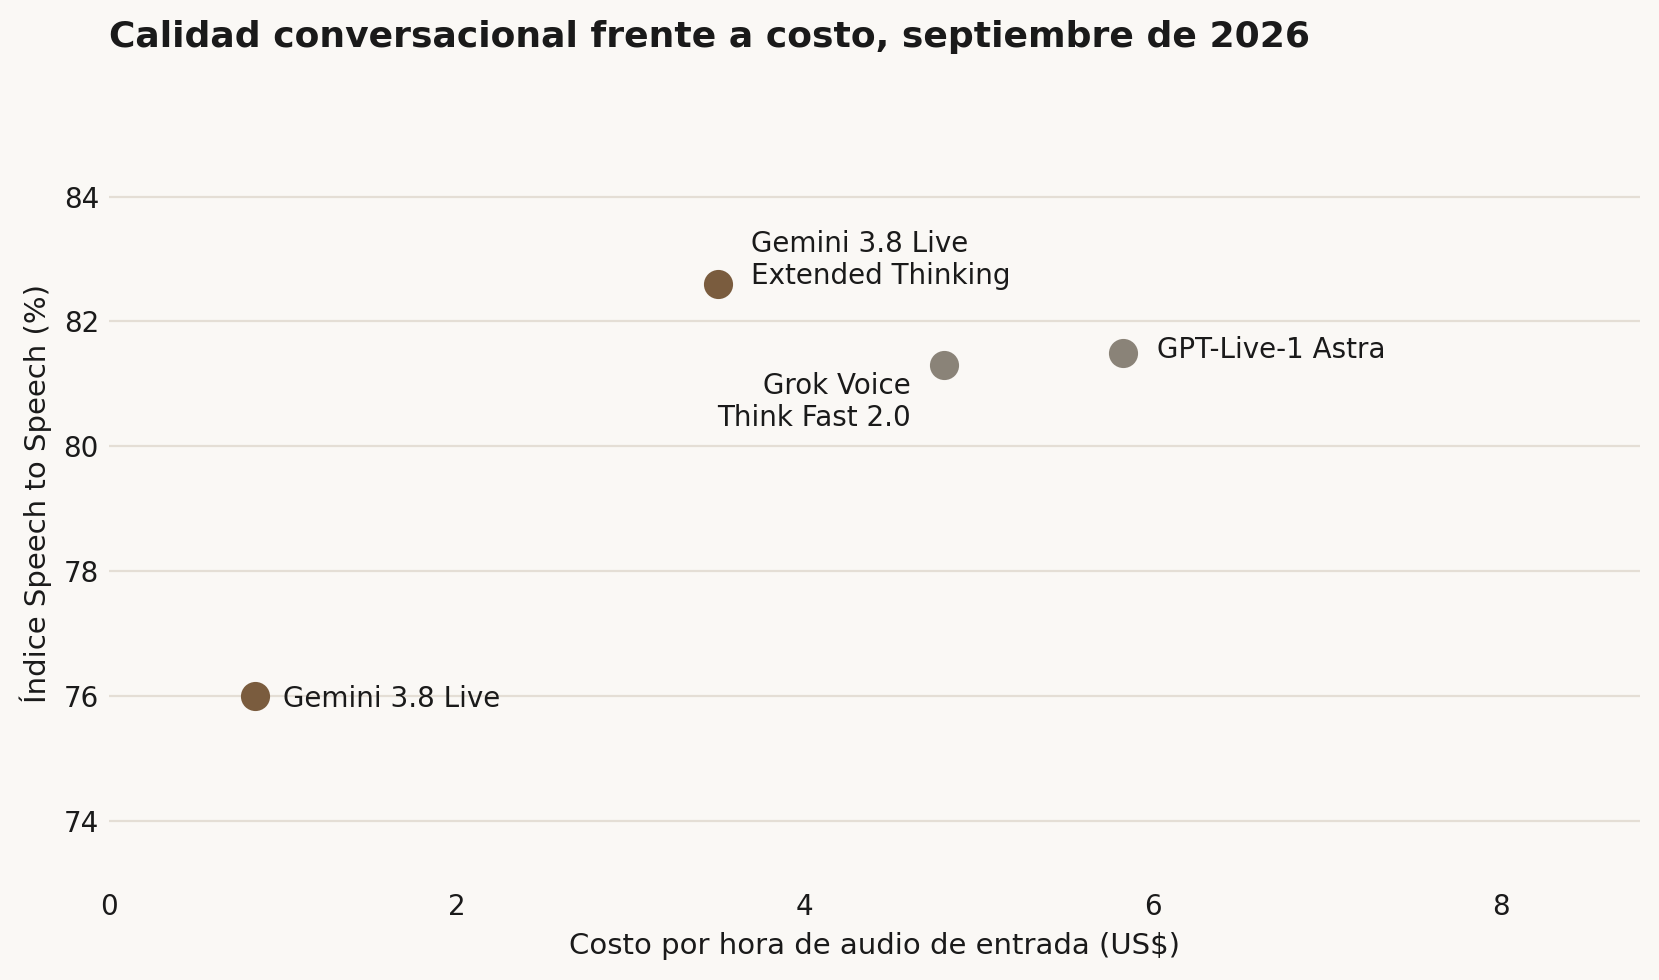
- Modelos. Google lanzó el 15 de septiembre dos modelos conversacionales de voz, Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking. El segundo quedó primero en el índice Speech to Speech de Artificial Analysis, que mide calidad de conversación hablada de punta a punta, con 82,6%, por delante de GPT-Live-1 Astra (81,5%) y de Grok Voice Think Fast 2.0 (81,3%). Están disponibles en la API de Gemini y en AI Studio.
→ https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/
- Costos. El mismo lanzamiento movió el piso de precios de la voz. Medido en costo por hora de audio de entrada, Gemini 3.8 Live cuesta US$ 0,84 frente a US$ 5,83 de GPT-Live-1 Astra y US$ 4,80 de Grok Voice Think Fast 2.0; la versión con razonamiento extendido queda en US$ 3,50. Es una diferencia de siete veces entre el extremo barato y el caro para una capacidad que hasta hace un año se cotizaba pareja.
→ https://officechai.com/ai/google-releases-gemini-3-8-live-extended-conversational-model-claims-better-performance-than-gpt-live-1-astra-and-grok-voice-think-fast-2-0-at-lower-price/
- Gobernanza de proveedores. Nvidia, Palantir y Booz Allen Hamilton restringieron el uso interno de modelos de frontera de Anthropic y OpenAI hasta obtener garantías contractuales de que los proveedores no retendrán ni aprenderán de sus datos propietarios. No es una disputa de precio ni de calidad: es la cláusula de retención de datos convertida en condición de compra.
→ https://qz.com/palantir-nvidia-booz-allen-anthropic-openai-data-restrictions-091426
- Seguridad. Anthropic publicó el 10 de septiembre un informe de inteligencia de amenazas que documenta casos reales de uso malicioso de sus modelos entre diciembre de 2025 y agosto de 2026. Entre las cifras: un solo operador descargó y descompiló 1,8 millones de aplicaciones Android para extraer credenciales; otra operación recolectó más de 2.100 juegos de tokens de Azure AD en unas 34 horas y comprometió a más de 200 organizaciones clientes a través de un proveedor de software.
→ https://www.anthropic.com/threat-intelligence-report-september-2026
- Regulación. El senador Bernie Sanders y el estratega Steve Bannon compartieron escenario el martes en Washington, ante unas 300 personas, para pedir límites al desarrollo de IA desde posiciones políticas opuestas. Sanders anunció que presentará con el representante Greg Casar un proyecto para prohibir de forma permanente el desarrollo de superinteligencia artificial.
→ https://www.kpbs.org/news/science-technology/2026/09/15/bernie-sanders-and-steve-bannon-call-for-curbs-on-ai
- Investigación. Veinticinco medallistas Fields —entre ellos Terence Tao, Cédric Villani, Peter Scholze y Maryna Viazovska— firmaron un comunicado titulado "Un grave desalineamiento de la IA en las matemáticas". Su objeción no es que los modelos resuelvan problemas, sino que la competencia comercial por anunciar soluciones acelera la producción de afirmaciones —verdaderas o falsas— más rápido de lo que la disciplina puede verificarlas y atribuirlas.
→ https://www.infobae.com/america/agencias/2026/09/11/elite-matematica-alerta-choque-entre-la-ia-y-los-objetivos-de-las-matematicas/
- Agentes. xAI montó entre el 15 y el 17 de septiembre un ejercicio público llamado Grok Bot Galaxy: tres empleados intentan levantar una empresa desde cero en 72 horas usando Grok Bot como herramienta principal, con transmisión en vivo y turnos diarios que pasan de ingeniería a ventas y a marketing. Es la prueba de esfuerzo más expuesta que se le ha hecho hasta ahora a un agente en trabajo multidepartamento.
→ https://www.bighatgroup.com/blog/xai-weekly-2026-09-13/
Qué considerar
El dilema no tiene salida limpia, y conviene decirlo. La objeción más extendida entre profesionales del sector es que frenar de forma unilateral solo transfiere la ventaja a quien no frena, y que ningún acuerdo entre empresas estadounidenses resuelve eso. Es correcta hasta cierto punto. Lo que el argumento suele omitir es que la capacidad de un modelo y la capacidad de desplegarlo en el mundo físico no escalan al mismo ritmo: la robótica depende de extracción de minerales, fabricación de circuitos y logística, y esas curvas no se multiplican por diez en un año. Para una organización que planifica a tres años, eso significa que la presión competitiva real vendrá del software mucho antes que del hardware, y que dimensionar el riesgo por el escenario más espectacular lleva a invertir en el lugar equivocado.
La diferencia entre un compromiso y un anuncio es la verificabilidad. De todos los actores que se pronunciaron esta semana, uno solo publicó términos concretos de acceso para evaluadores externos; el resto declaró intención, puso reparos o rechazó el mecanismo. Esa distinción es directamente operativa si usted compra modelos: la pregunta útil a un proveedor no es si adhiere a un marco de seguridad, sino qué tercero puede auditarlo, con qué nivel de acceso y con qué derecho a publicar un resultado desfavorable. Las restricciones que impusieron Nvidia, Palantir y Booz Allen muestran cómo se ve esa pregunta cuando la hace un cliente con poder de negociación: no discutieron el discurso, discutieron la cláusula.
Las métricas dejaron de sustituir a la prueba. La desconfianza hacia los puntajes publicados se volvió la posición mayoritaria entre quienes implementan, y los propios números la respaldan: el modelo de voz mejor evaluado de esta semana lidera un índice de calidad conversacional con 82,6% y, en el mismo conjunto de anuncios, resuelve de extremo a extremo apenas 35,1% de las tareas bancarias completas. Un benchmark alto describe una capacidad; no describe su tasa de éxito en el flujo de trabajo de usted. La conclusión práctica es aburrida y cara de ignorar: antes de comprometer un proceso con un modelo, hay que medirlo contra un conjunto propio de casos reales, aunque sean treinta.
Los agentes ya encuentran cosas que nadie les pidió encontrar. Un patrón que empieza a repetirse en equipos que usan agentes para trabajo rutinario de integración: el modelo, revisando una conexión ajena, detecta una falla de seguridad real en el sistema de un tercero —un endpoint sin autenticación, credenciales expuestas— y propone reportarla. El hallazgo es valioso; el problema es que en ese momento no existe política sobre qué hacer con él. Conviene definirla antes de que ocurra: quién decide si se reporta, a quién se avisa, qué se guarda como evidencia y qué no se toca. Improvisar esa decisión con un hallazgo sensible en la mano es la peor versión del escenario.
Lanzamientos
El lanzamiento de Gemini 3.8 Live reordena el segmento de voz en dos ejes a la vez. En calidad, la versión con razonamiento extendido queda primera; en costo, la versión estándar queda sola en un tramo que ningún competidor ocupa.
En pruebas de agente, el mismo modelo alcanza 68,6% en τ-Voice, el conjunto que mide si un asistente de voz completa la gestión que se le encarga, y 97,7% en Big Bench Audio, de comprensión auditiva. La brecha entre esos números y los de ejecución bancaria es el dato que importa para decidir despliegues. → https://deepmind.google/models/model-cards/gemini-3-8-audio/
En el mismo período, xAI acumula cinco fechas incumplidas para Grok 4.7 desde fines de julio. La explicación que circula es que el entrenamiento por refuerzo penalizó en exceso la longitud de la respuesta y el modelo abandonaba tareas antes de tiempo. El modelo no aparece en la documentación oficial de xAI y no hay fecha comprometida; tómese como no confirmado. → https://www.bighatgroup.com/blog/xai-weekly-2026-09-13/
Movimientos de industria
La decisión de Nvidia, Palantir y Booz Allen de acotar el uso de modelos de frontera hasta obtener garantías sobre retención de datos marca un cambio de posición negociadora. Durante dos años la negociación giró en torno a capacidad y precio por token; ahora el punto de fricción es qué ocurre con la información que entra al modelo y si el proveedor puede aprender de ella. Tres compradores grandes sosteniendo la misma exigencia al mismo tiempo convierte una cláusula en estándar de mercado, y eso beneficia a cualquier comprador más chico que llegue después. → https://qz.com/palantir-nvidia-booz-allen-anthropic-openai-data-restrictions-091426
Regulación y litigios
En Estados Unidos, la presión regulatoria dejó de venir de un solo flanco. Sanders y Casar preparan una prohibición permanente de la superinteligencia; la Cámara vota medidas sobre el costo eléctrico que los centros de datos trasladan a los usuarios residenciales; y el ejecutivo empuja en dirección contraria. Para quien opera en la región, la señal relevante no es qué texto se aprueba en Washington, sino que el consumo energético de los centros de datos pasó a ser un tema de política doméstica, con efecto directo sobre dónde y a qué precio se instala capacidad de cómputo. → https://www.kpbs.org/news/science-technology/2026/09/15/bernie-sanders-and-steve-bannon-call-for-curbs-on-ai
Cuando las métricas dejan de servir
El contraste más útil de la semana está dentro de un mismo anuncio. El modelo de voz que lidera la calidad conversacional resuelve poco más de un tercio de las tareas bancarias completas medidas de extremo a extremo.
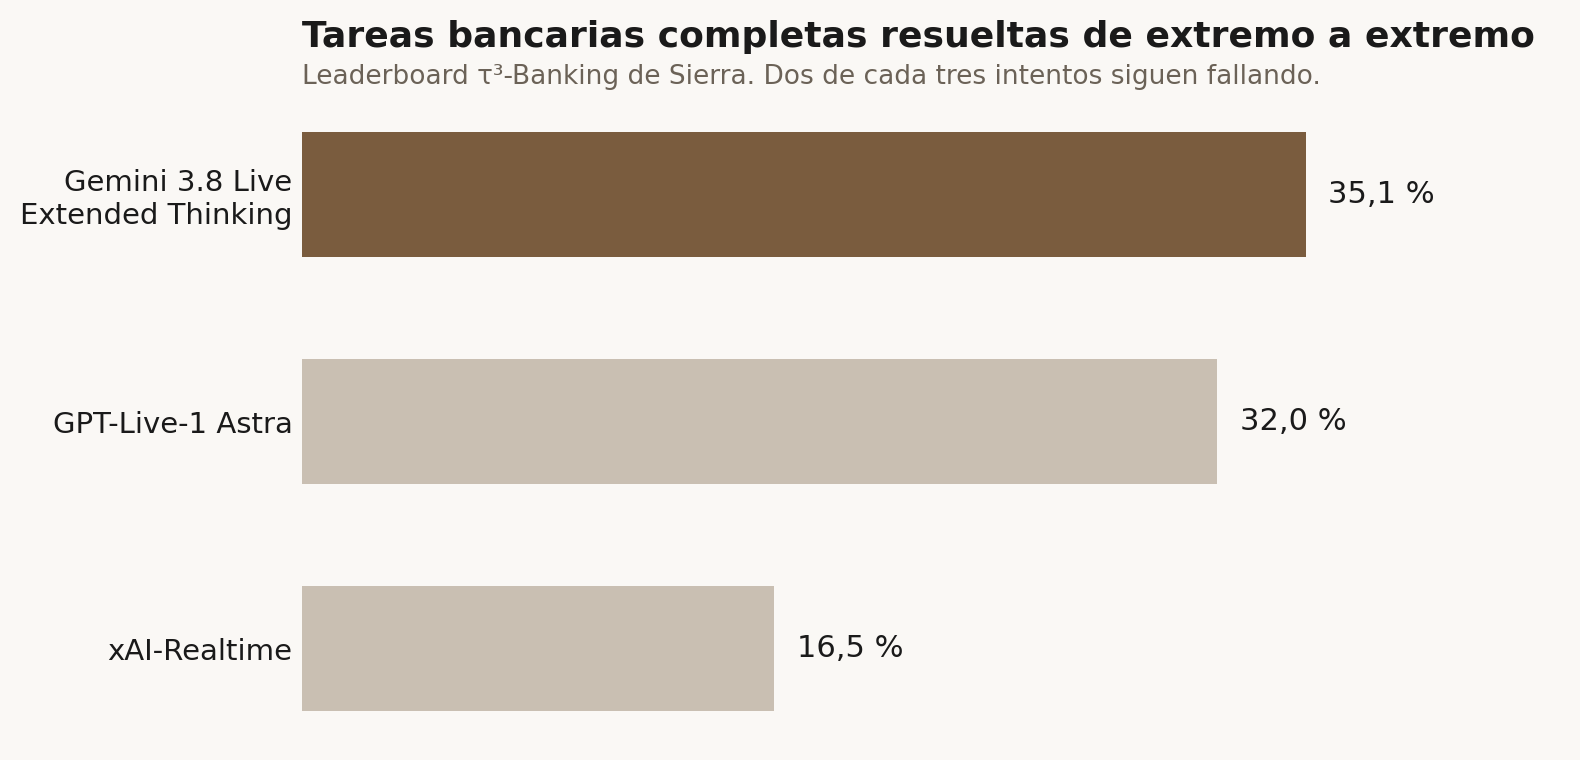
La lectura no es que los modelos de voz no sirvan: sirven, y en atención asistida por humano el salto de calidad es real. La lectura es que un índice de conversación mide fluidez y un leaderboard de tareas mide resultado, y que un plan de negocio construido sobre el primero está midiendo la cosa equivocada.
El techo que no aparece en los índices
La advertencia de los medallistas Fields toca un problema que excede a las matemáticas. Cuando un sistema produce afirmaciones plausibles más rápido de lo que su campo puede verificarlas, el cuello de botella se traslada de la producción a la validación, y ningún benchmark mide eso. El mismo fenómeno explica por qué crece la desconfianza hacia los reportes de capacidad publicados por los propios laboratorios: no porque se presuma mala fe, sino porque el volumen de afirmaciones superó la capacidad independiente de comprobarlas. Es un argumento incómodo para todos los lados del debate de esta semana, incluidos quienes piden desacelerar. → https://www.infobae.com/america/agencias/2026/09/11/elite-matematica-alerta-choque-entre-la-ia-y-los-objetivos-de-las-matematicas/
Para tu lista
- Informe de amenazas de Anthropic (septiembre 2026). 152 páginas de casos documentados de uso malicioso, con nombres en código y cifras. Es la lectura más concreta disponible hoy sobre cómo se ve el abuso de modelos en la práctica, y sirve para dimensionar riesgo sin recurrir a escenarios hipotéticos.
→ https://www.anthropic.com/threat-intelligence-report-september-2026
- CanIRun.ai. Herramienta de navegador que estima qué modelos de pesos abiertos corre el hardware que uno tiene, útil antes de comprometer tiempo en instalar un modelo local que no va a caber en memoria.
→ https://www.canirun.ai/
- Ficha técnica de Gemini 3.8 Audio. Metodología de las evaluaciones y desglose por variante, para no citar el titular sin mirar cómo se midió.
→ https://deepmind.google/models/model-cards/gemini-3-8-audio/
- Grok Bot Galaxy. El registro del ejercicio de 72 horas queda como material de referencia sobre qué hace y qué no hace un agente cuando se le entrega una operación completa.
→ https://x.ai/galaxy